为什么无法控制LLM每次都输出一模一样的内容?
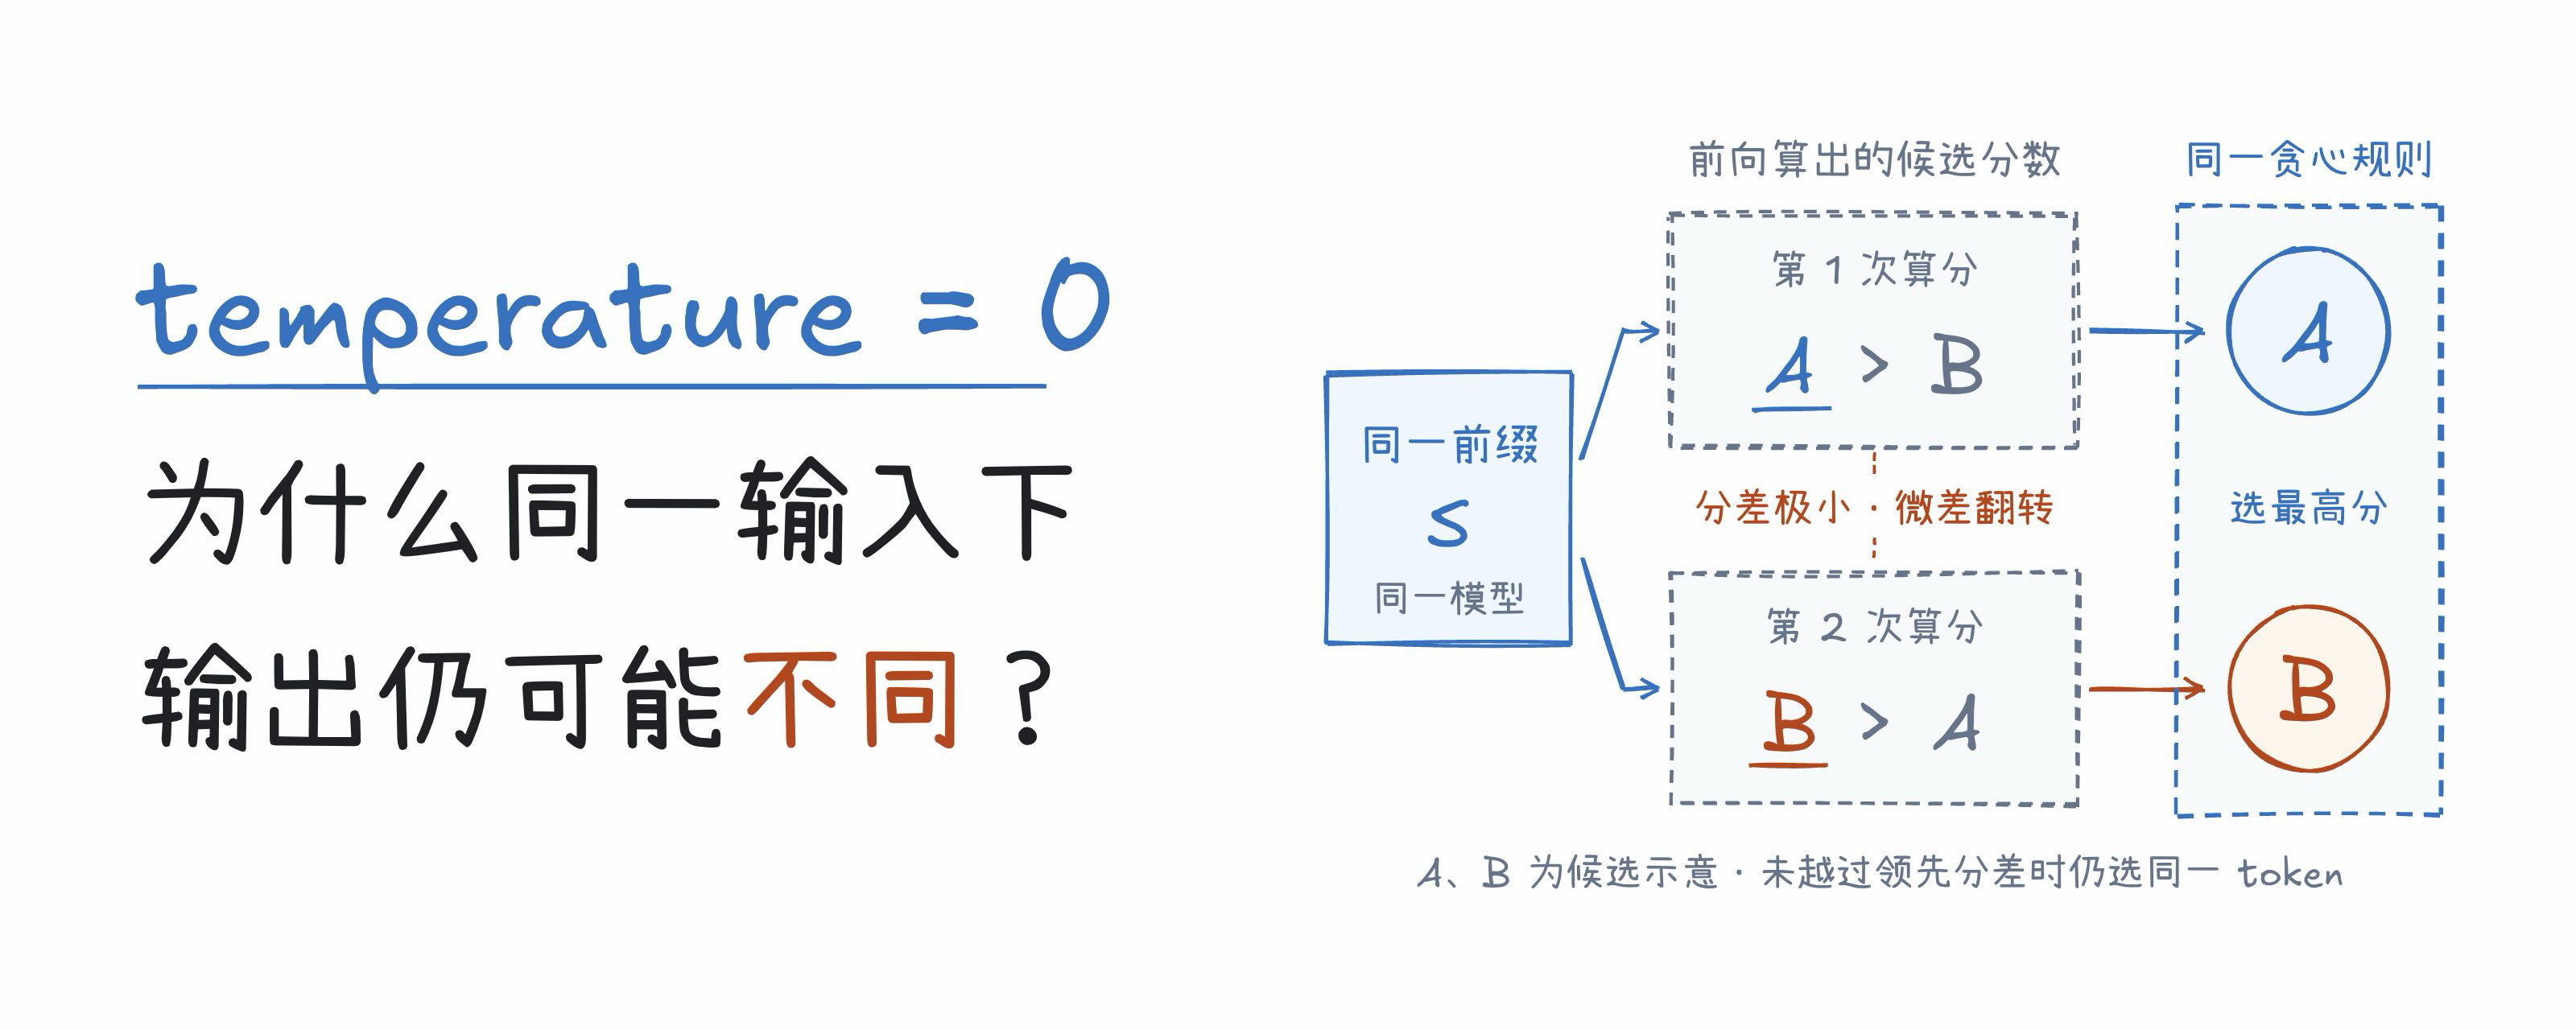
TL;DR:因为无法保证每次给LLM固定的完整输入与前向计算,所以做不到。如果两个候选词的排名非常接近,他们的候选概率会受动态批处理与浮点舍入影响而出现排名前后的变化。要实现逐字一致,需配合确定性计算等工程控制,或复用同一有效结果缓存原样返回答案。
temperature=0 与贪心解码的作用范围
大模型每步生成文本时,将当前 token 序列送入模型做前向计算,算出词表各候选的未归一化分数 logits,再由解码器选出下一个 token 追加到输入末尾 [1]。
拿到候选分数后,解码器按解码策略选词 [2]。随机采样通过随机数发生器(RNG)按候选概率分布抽样,temperature 用于调节分布平缓程度。数学上不能将 直接代入 。若接口将 temperature=0 实现为进入贪心解码分支,解码器在该设置下不抽样,直接取最高分候选词:
只要分数 的最高分排名不变且并列处理规则固定,贪心解码与同样取最高分的 Top-K=1 选出的 token 就唯一确定。各接口的参数语义由具体实现决定,并非都接受 temperature=0 或将其实现为贪心解码。例如 Hugging Face Transformers 用 do_sample=False 且 num_beams=1 指定贪心解码,设为 do_sample=True 且 num_beams=1 则执行多项分布随机采样 [1, 2]。
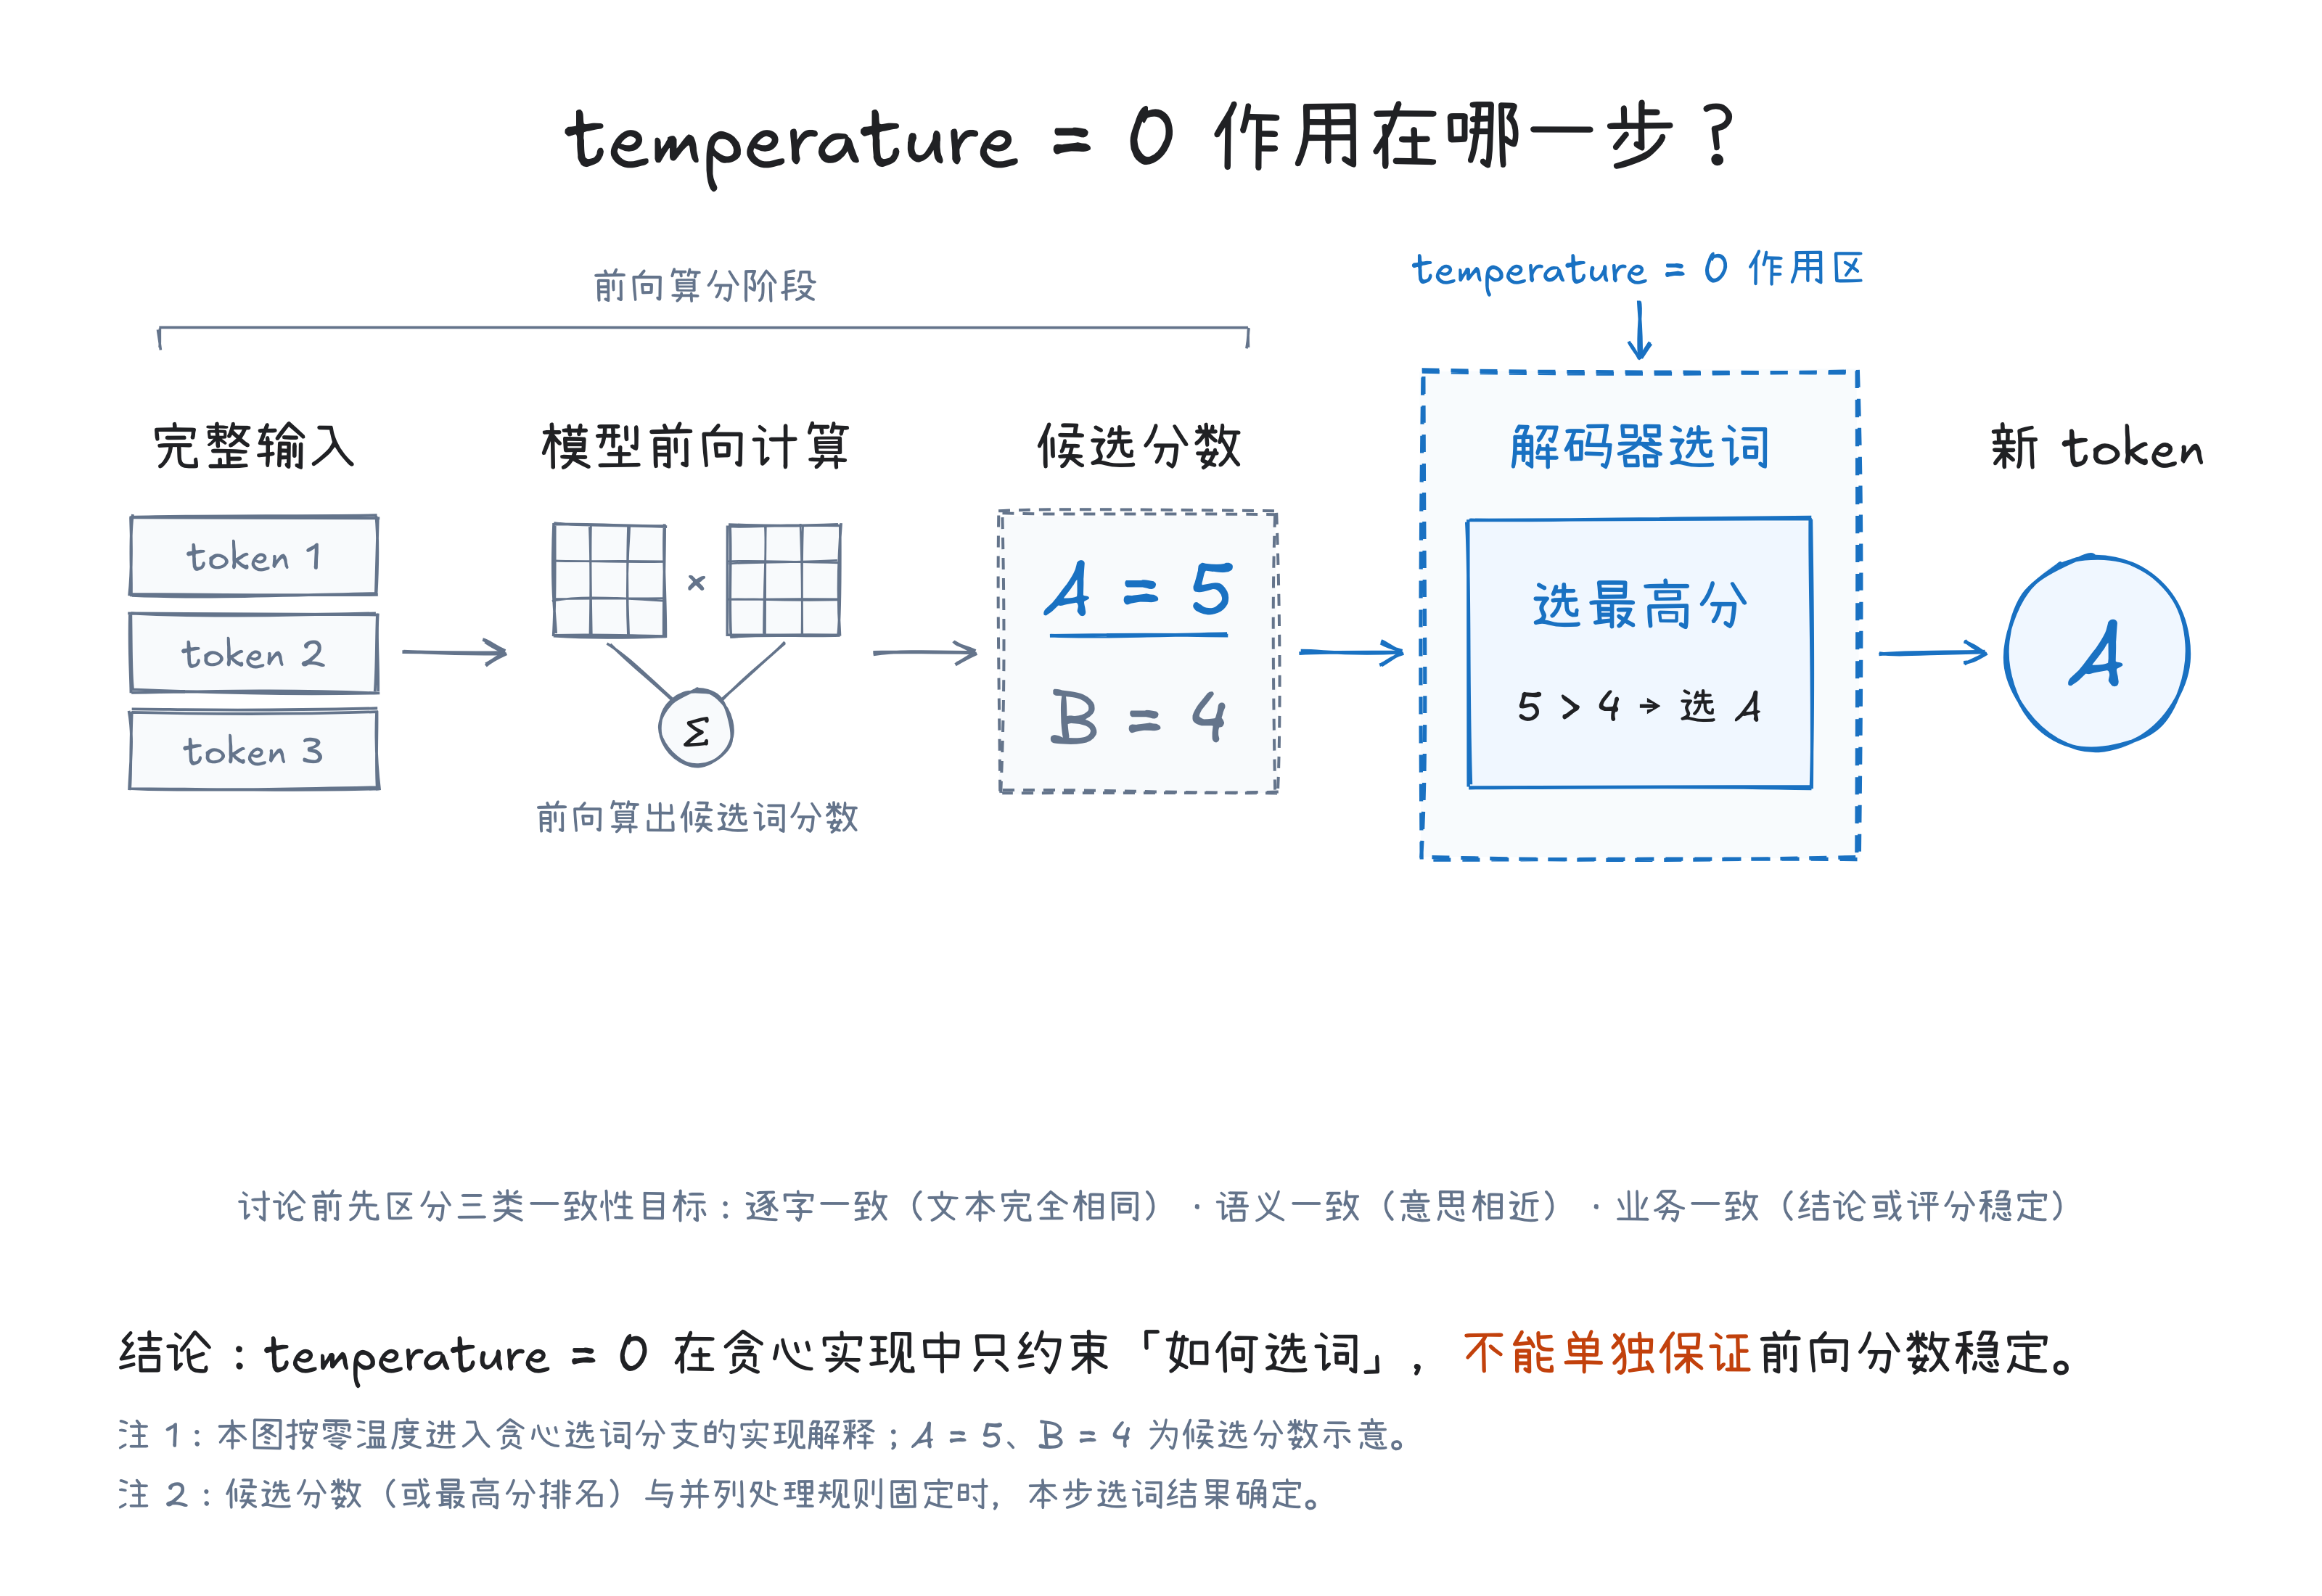
贪心解码只固定了算出分数后的选词规则,并未固定选词前的输入条件与算分过程。即便不要求所有中间数值逐位相同,只要完整输入、服务端模型配置或前向计算算出的最高分排名发生变化,贪心解码选出的 token 序列就可能改变。
完整输入拼接与服务端配置差异
模型接收的完整输入由应用层拼接而成,不只是界面上的一句提问。应用在发起推理前,常会拼入系统指令、多轮历史、时间戳、RAG 检索片段或工具返回结果,再由聊天模板将各角色的消息列表渲染成带控制符的 token 序列。任一字段或模板逻辑变化,都可能改变最终送入模型的 token 序列 [3]。
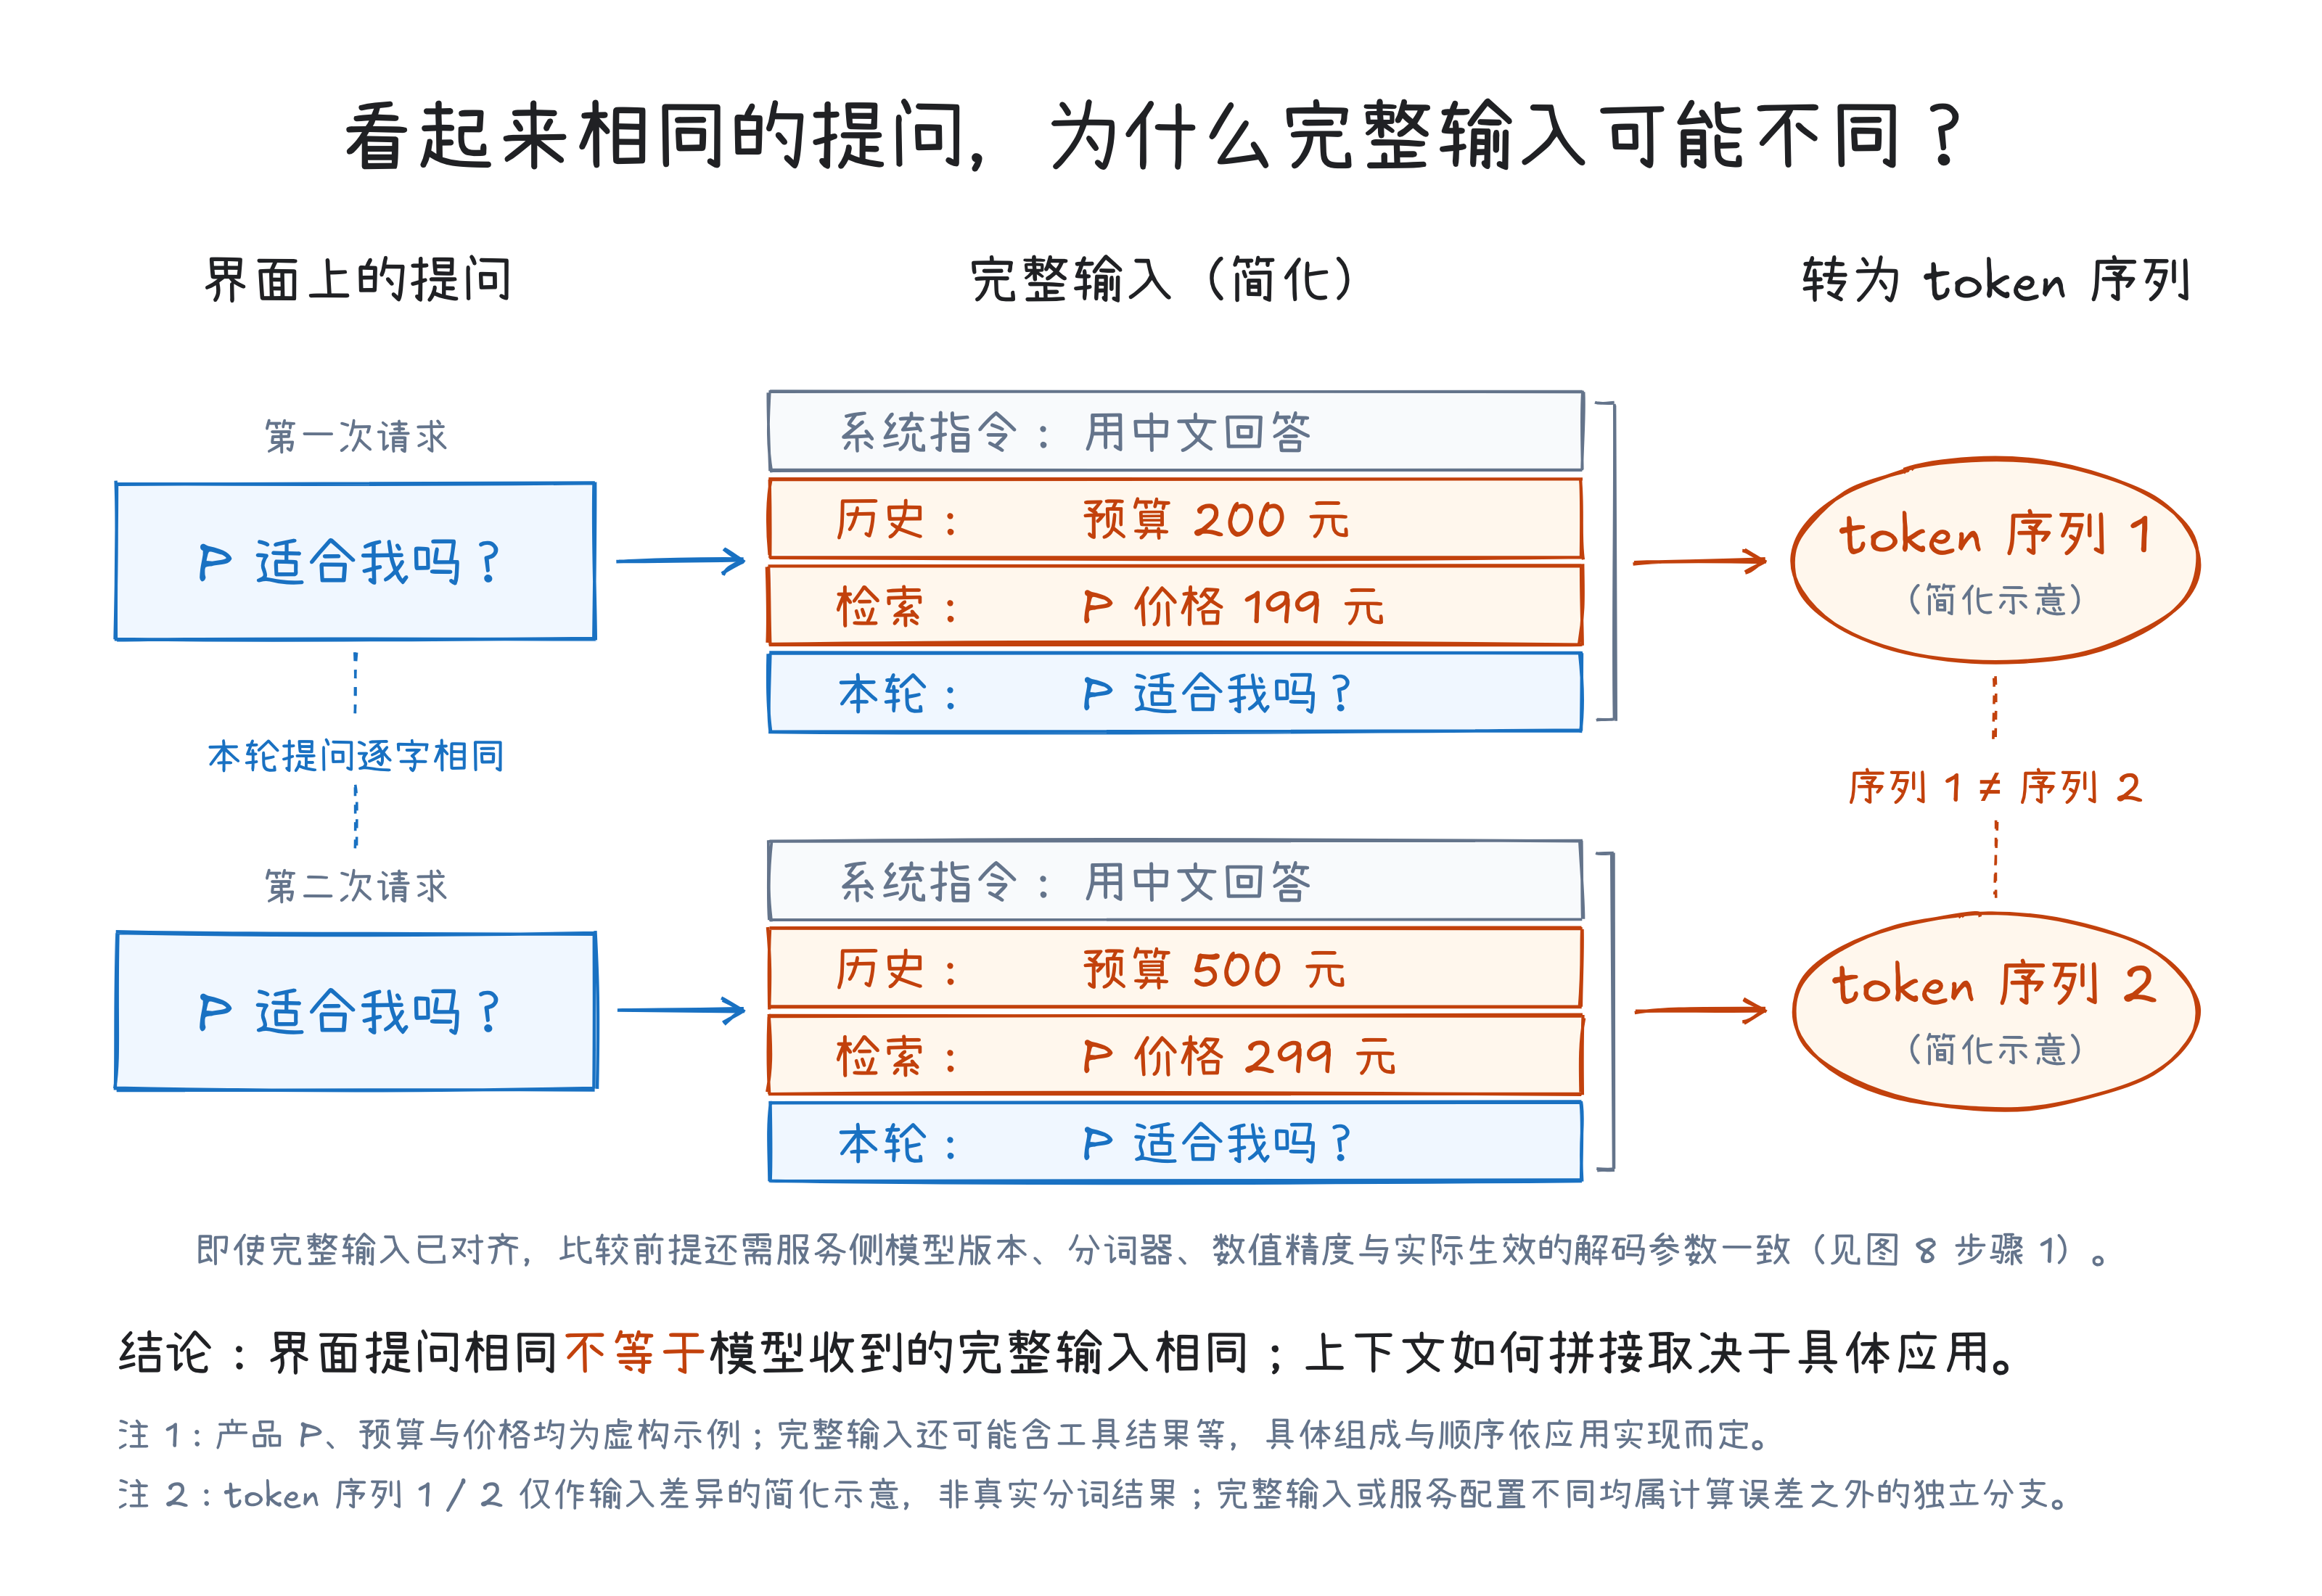
例如两次提问表面都是“P 适合我吗?”,系统指令不变,但拼入的历史或检索内容从“预算 200 元、P 价格 199 元”变成“预算 500 元、P 价格 299 元”,分词后进入模型的就是不同序列。服务端配置同理:调用时传入相同模型名,不代表后端加载了同一权重 checkpoint、分词器、量化与精度设置,或相同的生效解码参数。完整输入或服务端配置不同,模型的输入条件就不同,输出可能随之变化。
动态批处理与跨 batch 数值变化
即便完整输入 token 序列与服务端配置完全一致,前向计算算出的候选分数仍可能出现微小差异。线上推理服务为兼顾吞吐量,会通过动态批处理把可一起执行的多条请求拼成一个 batch 并行计算。动态批处理不会把其他请求的文本混入当前上下文,各请求的注意力计算彼此独立。但同一请求先后与不同数量请求拼成 batch = 2 和 batch = 4 时,进入算子的张量形状会改变。请求分配到不同 GPU 硬件、驱动或推理后端时,调用的算子实现也可能不同。
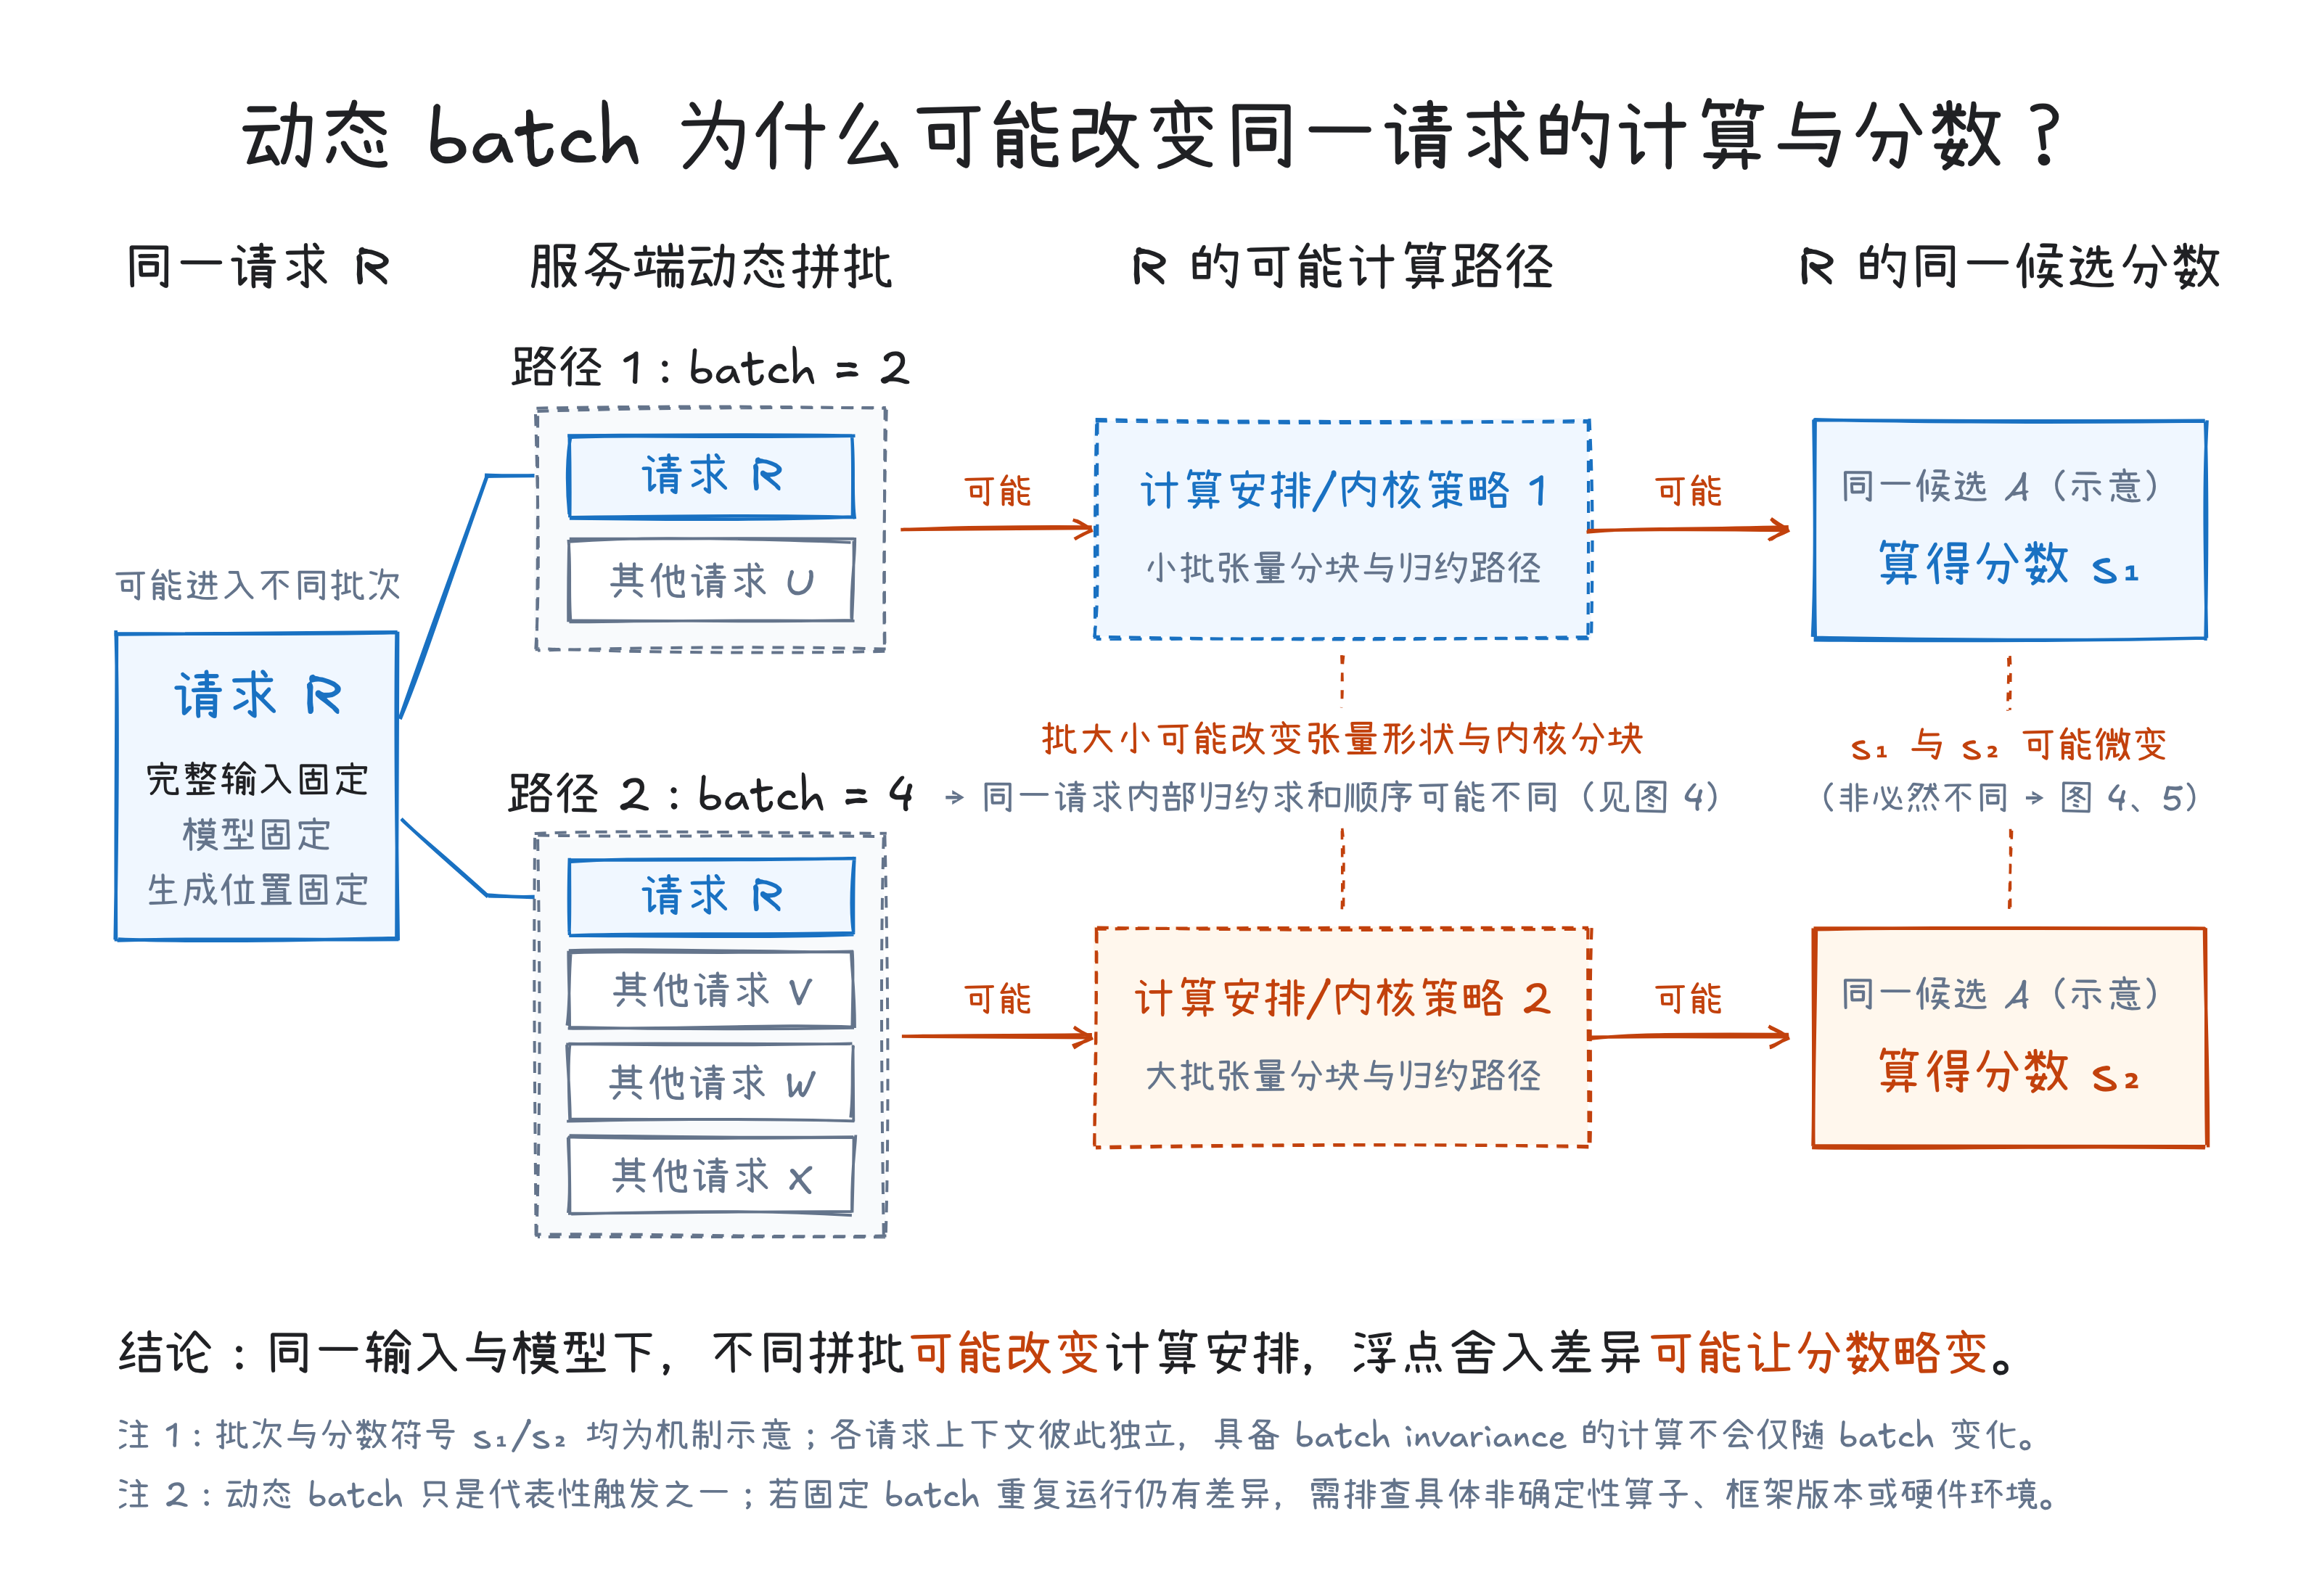
张量形状或运行环境变化后,推理引擎与算子库可能改用不同的内核、矩阵分块、并行归约求和顺序或精度,使同一候选词算出略有差异的分数 和 。分析这类分数变化需区分两种不同范围的稳定性性质:
- 同配置同 batch 的重复确定性:在同一硬件、软件版本与配置下,固定相同 batch 重复执行时结果保持一致的性质。若固定相同 batch 和环境重跑仍有变化,应排查原子累加等非确定性操作或未对齐的配置,不能直接断言 GPU 硬件本身随机。
- 跨 batch 数值不变性(batch invariance):同一请求无论单独运行,还是与不同数量、不同内容的请求拼成不同 batch 运行,算出的数值都保持一致的性质 [4, 5]。
满足同配置同 batch 重复确定性的算子实现,在批大小或批内请求组合变化时,可能因分块与归约顺序改变而算出不同数值,因此不一定具备跨 batch 数值不变性。
浮点加法非结合性与归约舍入差异
归约求和顺序影响候选分数,是因为有限精度浮点数尾数位宽固定、每步加法后都要舍入。浮点加法满足交换律 ,却不满足结合律,改变求和顺序时 与 不保证相等:
因此批处理与单条计算之间、不同硬件或软件版本之间,即便数学表达式等价,只要求和顺序不同,计算结果就不保证逐位相同 [6]。
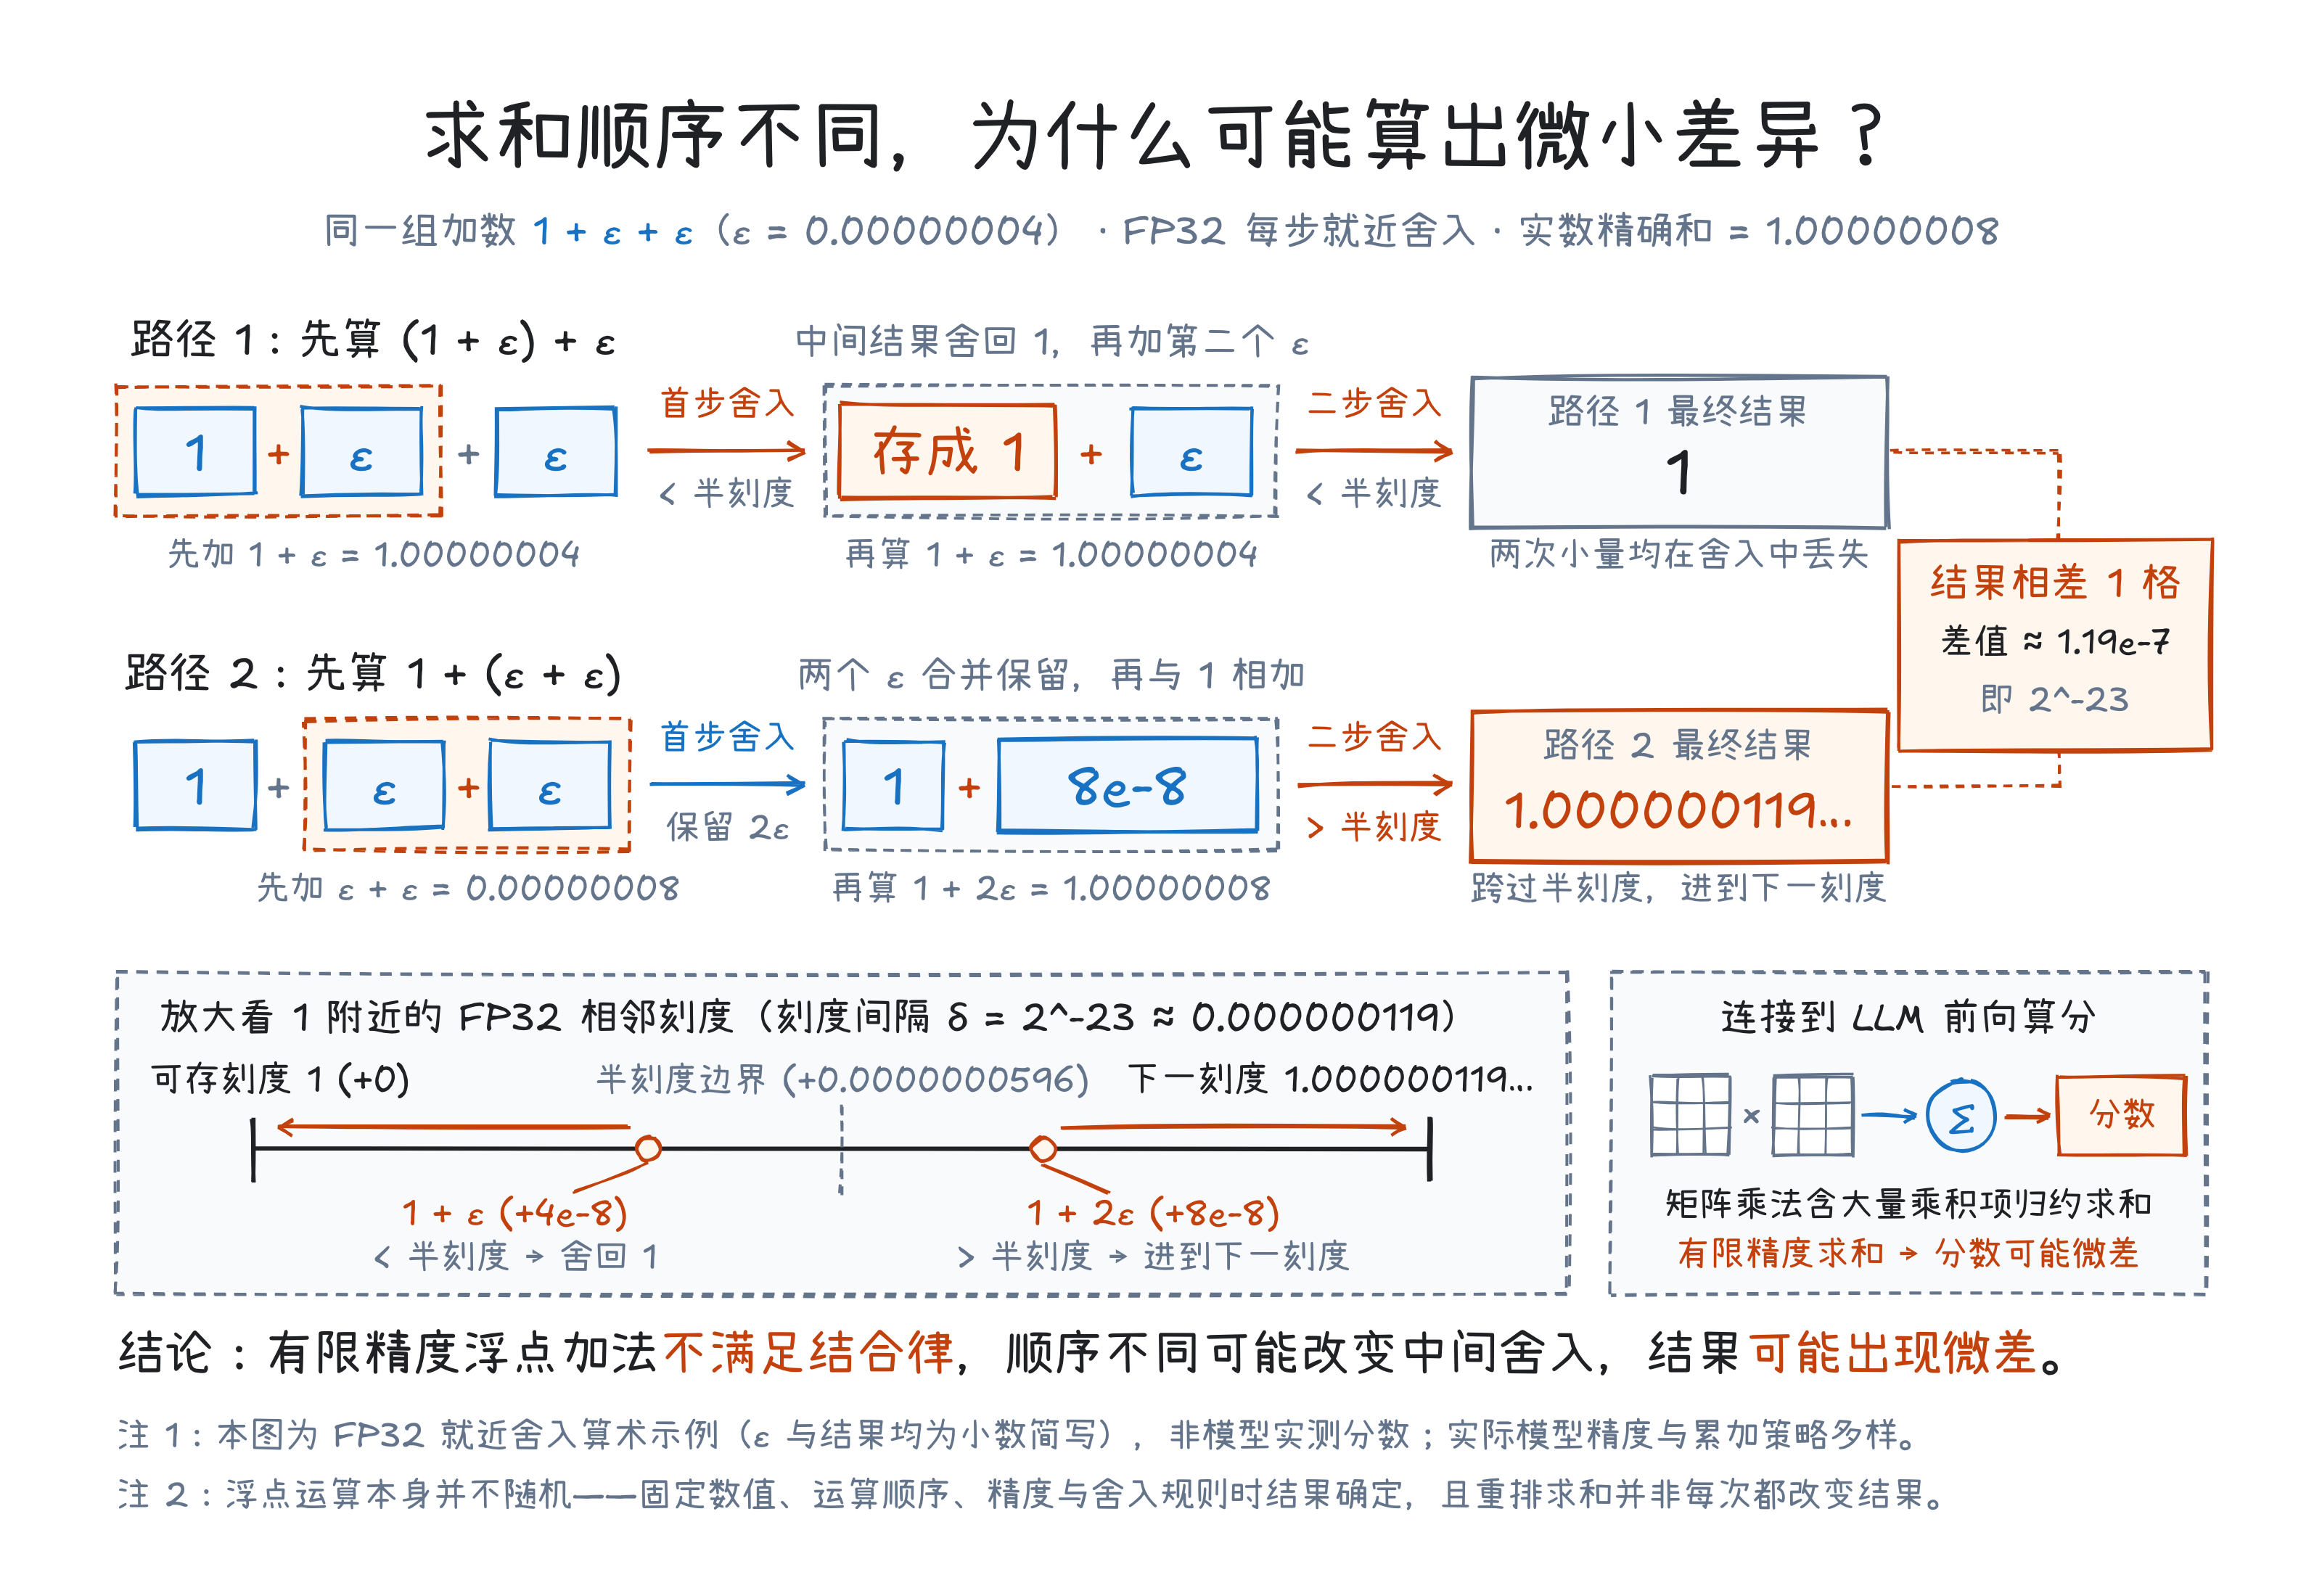
以 32 位单精度浮点数 FP32(每步按最近偶数舍入)计算 为例,取 (十进制简写 0.00000004)。FP32 在 上方的相邻可表示数间距为 ,下一刻度为 1.0000001192092896,半刻度舍入阈值为 :
左结合中两个 先后单独加到 上,均未超过半刻度阈值 ,舍入后仍为 。右结合先相加得 ,再加 时超过阈值并进位。前向计算的矩阵乘法与向量内积需归约累加大量乘积项,归约顺序变化便可能产生此类舍入差异。该算术示例仅演示舍入规则,非大模型实测,也不代表实际部署均用 FP32。输入、求和顺序、精度与舍入规则固定时,浮点运算按固定规则执行,不含随机抽样;改变归约顺序也只是可能改变舍入结果,并非每次重排都会算出不同数值。
最高分排名翻转与自回归序列分叉
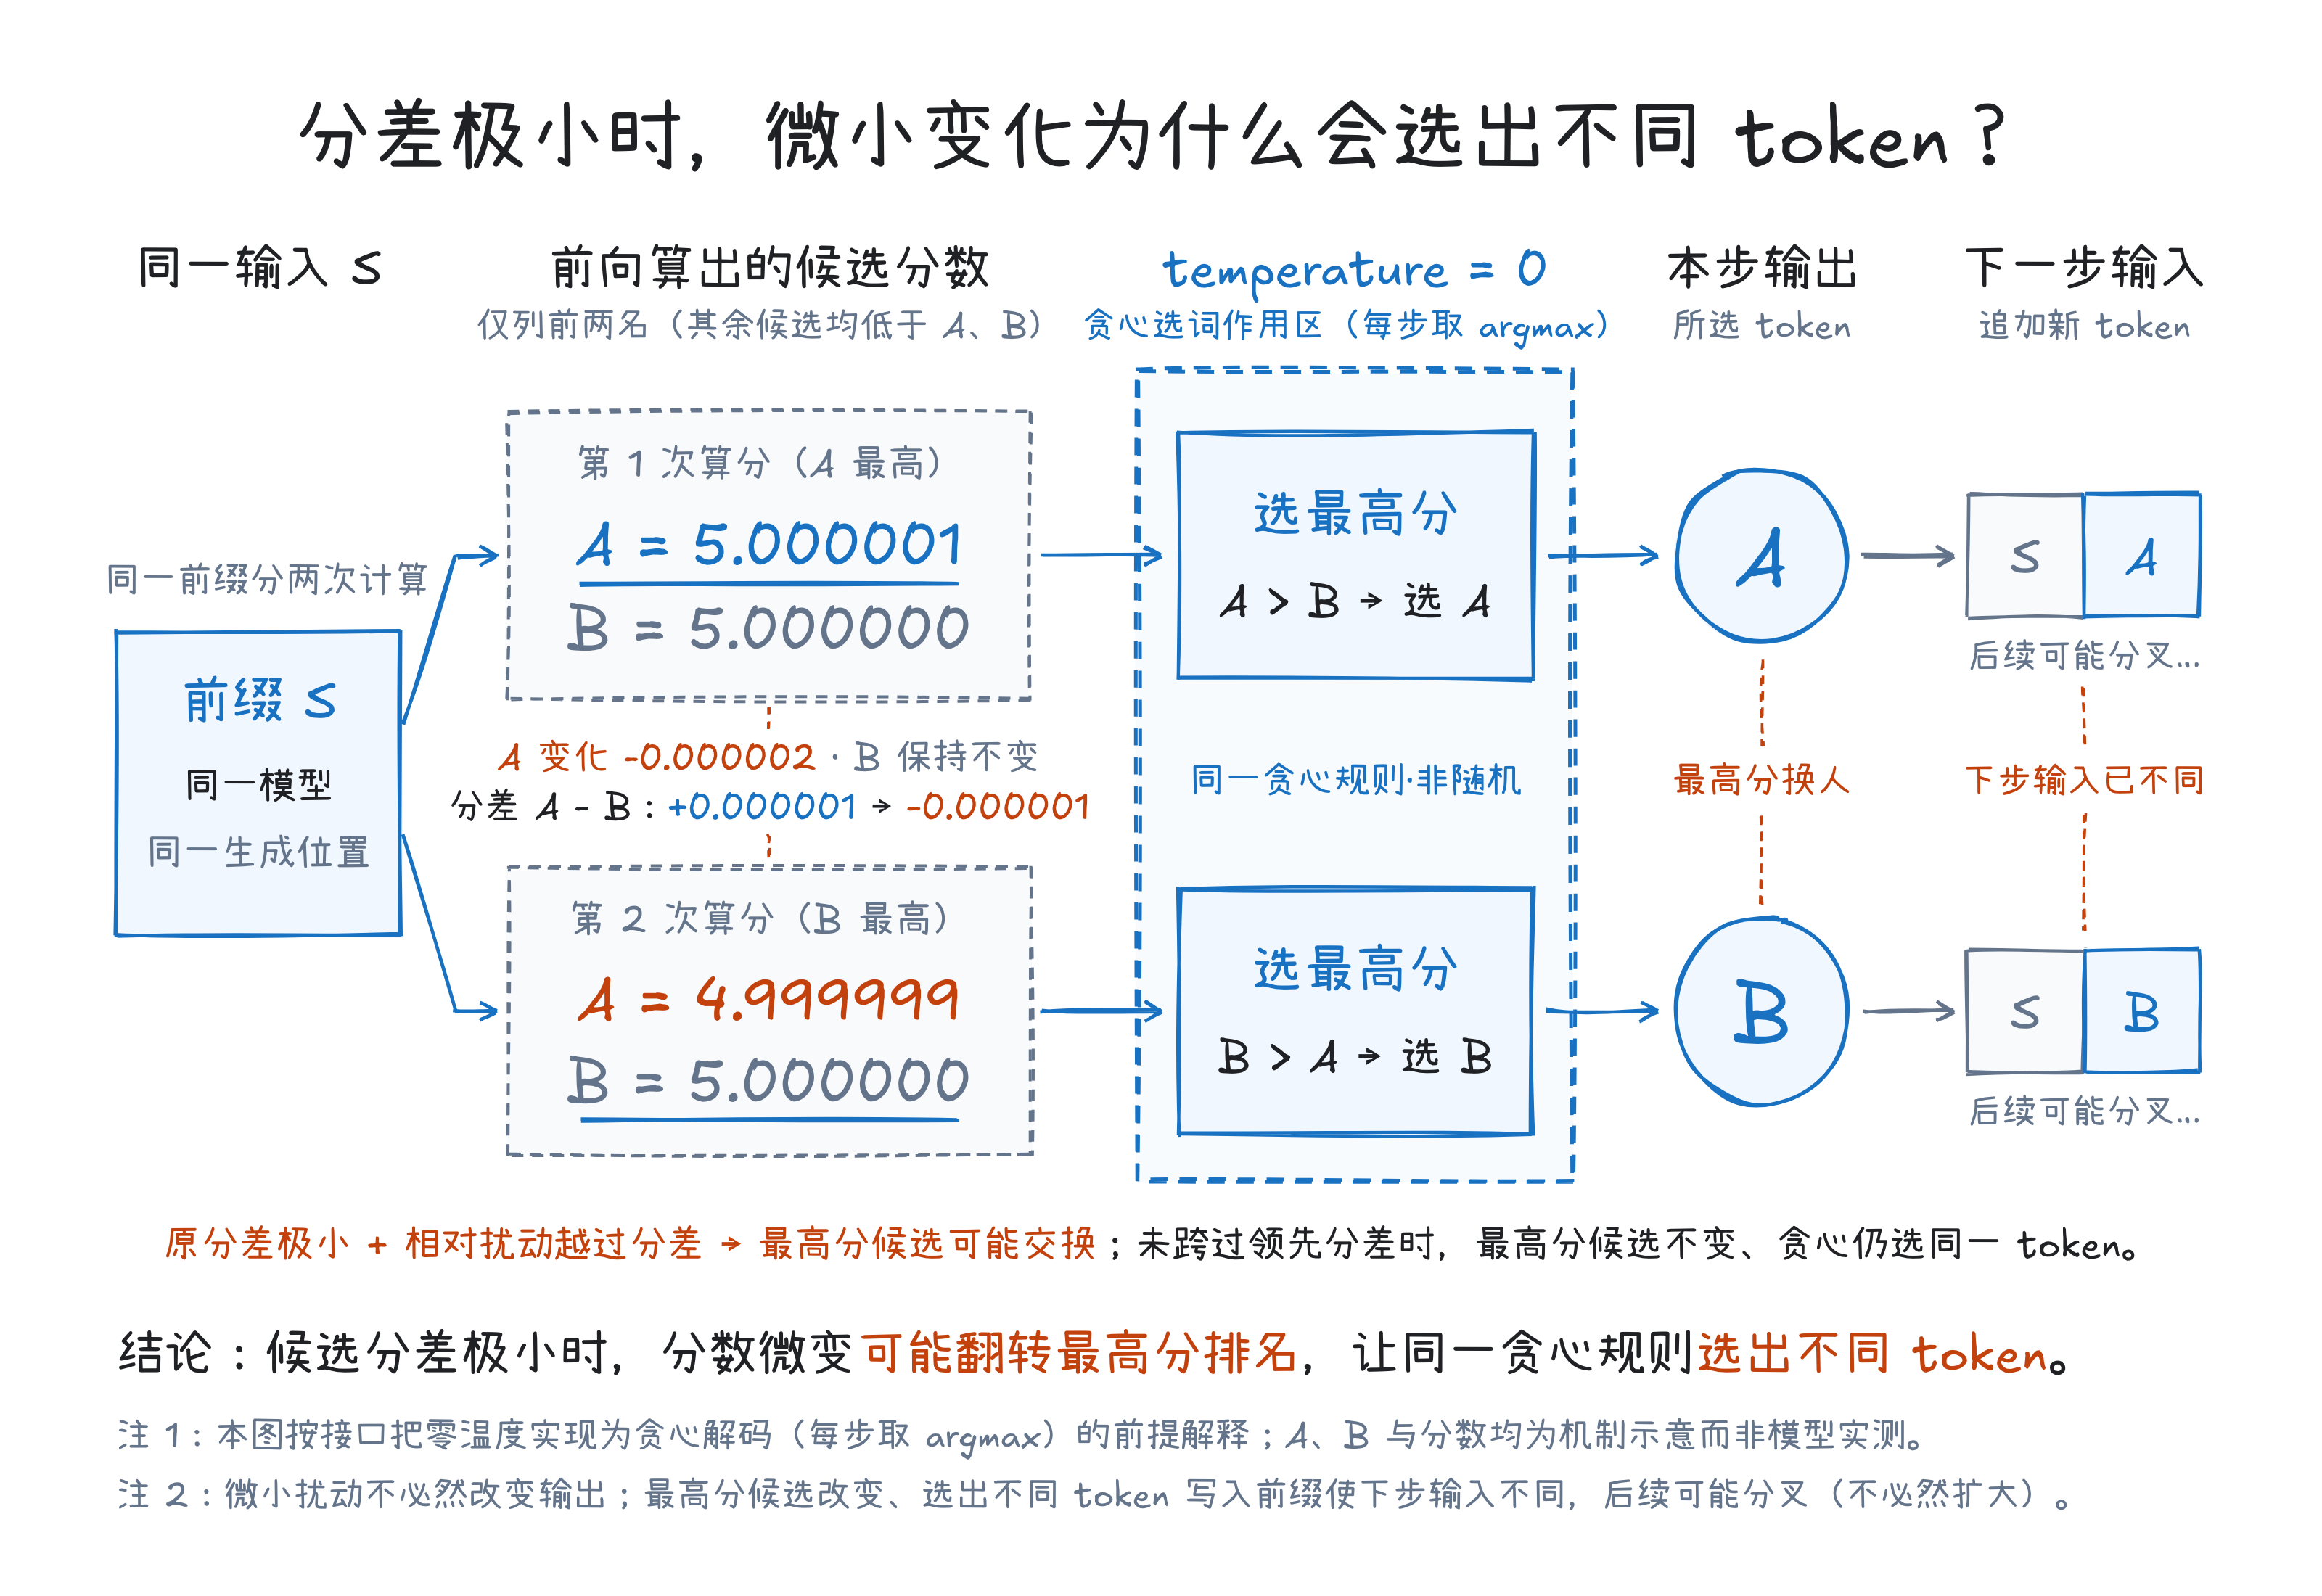
微小的分数差异不一定改变贪心解码的输出:若候选词的相对分数变化改变了最高分归属(例如排名前列的候选词原本分差极小,微小舍入误差即可翻转先后顺序),贪心解码就会改选其他 token;若相对分数变化未改变最高分排名,则仍选出原 token,最高分完全并列时按固定规则选词。例如在同一前缀 、同一模型和生成位置下,前两名候选词 A 和 B 第一次算得 、,分差 ,解码器选出 A;第二次因归约顺序变化算得 、,分差变为 ,两者的排名前后调换,解码器改选 B(分值仅作示例)。
一旦某步 token 从 A 变为 B,下一步送入模型的前缀就从 变为 ;由于输入前缀已经不同,后续步骤的分差与选词变化不能再当作同一输入下的浮点舍入误差来比较。此后生成的文本序列可能继续分化,但不同词句仍可能表达相同的核心意思,未必在语义上越偏越远。
随机种子与确定性算子的控制边界
随机种子 seed 用于初始化或设定伪随机数发生器(RNG)的状态,本身不能固定前向浮点归约顺序或服务端动态批处理。零温度贪心解码在选词时不调用采样 RNG,因此仅靠设置 seed 无法消除贪心解码下的输出变化。即便在随机采样下固定了 seed、RNG 算法和调用次序,只要前向分数变化引起候选概率分布发生微小偏移,同一随机数序列作用于偏移后的分布时,仍可能抽中不同 token [7]。
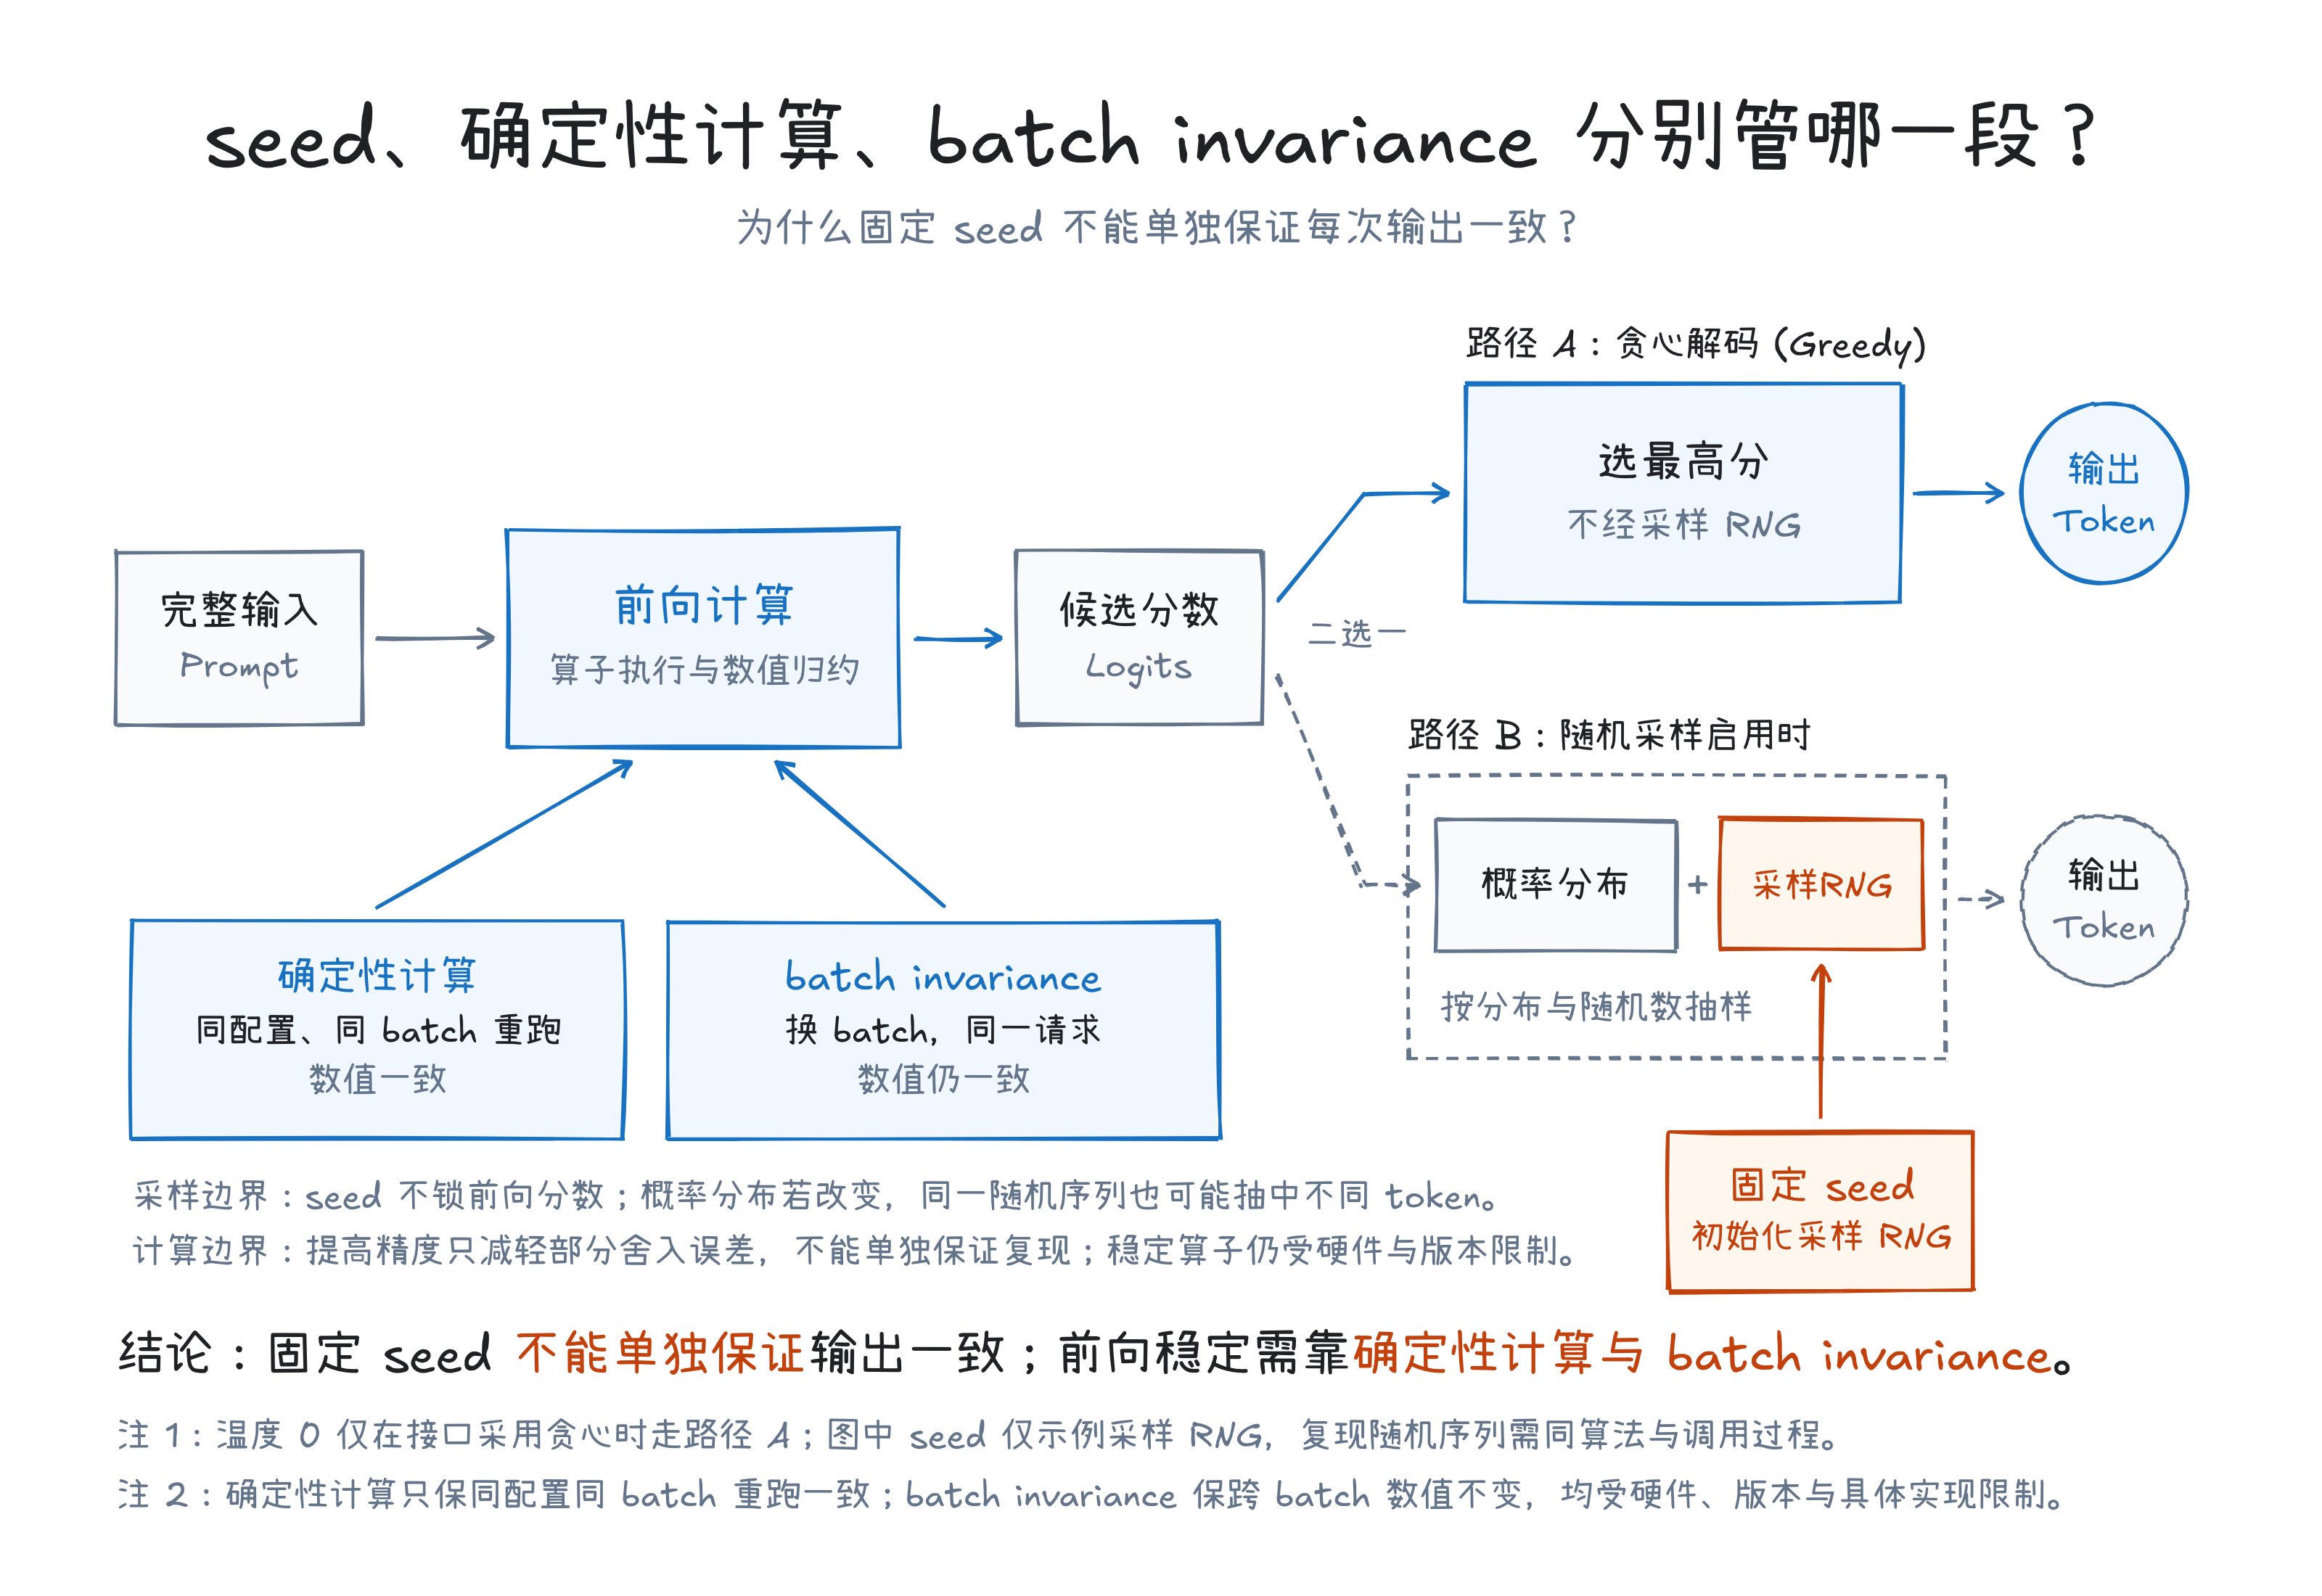
要在自部署推理服务中固定前向分数,需要分别针对同批计算与跨批计算做控制:启用确定性算子可固定同配置、同 batch 下的计算与归约过程 [7];启用 batch-invariant 实现则使同一请求的前向数值结果不随批大小或批内请求组合而改变 [4, 5]。不过 vLLM 等推理引擎默认优先保障吞吐与延迟,不保证逐位可复现 [8]。确定性算子及部分框架中尚处 beta 阶段的 batch invariance,均受 GPU 架构、软件版本与算子支持范围限制,开启后通常会降低吞吐或增加延迟,性能影响需在目标环境实测。
单纯提高数值精度或累加位宽可减轻部分舍入误差,但浮点加法依然不满足结合律,不能单独保证端到端数值或输出一致。此外,权重初始化、数据洗牌、Dropout 与分布式反向传播等训练随机性改变的是模型权重,不能直接解释固定权重推理时的输出变化。
结果缓存、KV 缓存与格式约束的区别
外部托管 API 是否开放底层算子与批处理配置取决于具体服务实现,自部署服务有时也会因性能开销而不开启固定归约。若要求相同请求直接拿到相同返回文本,可在应用层或网关层引入结果缓存。
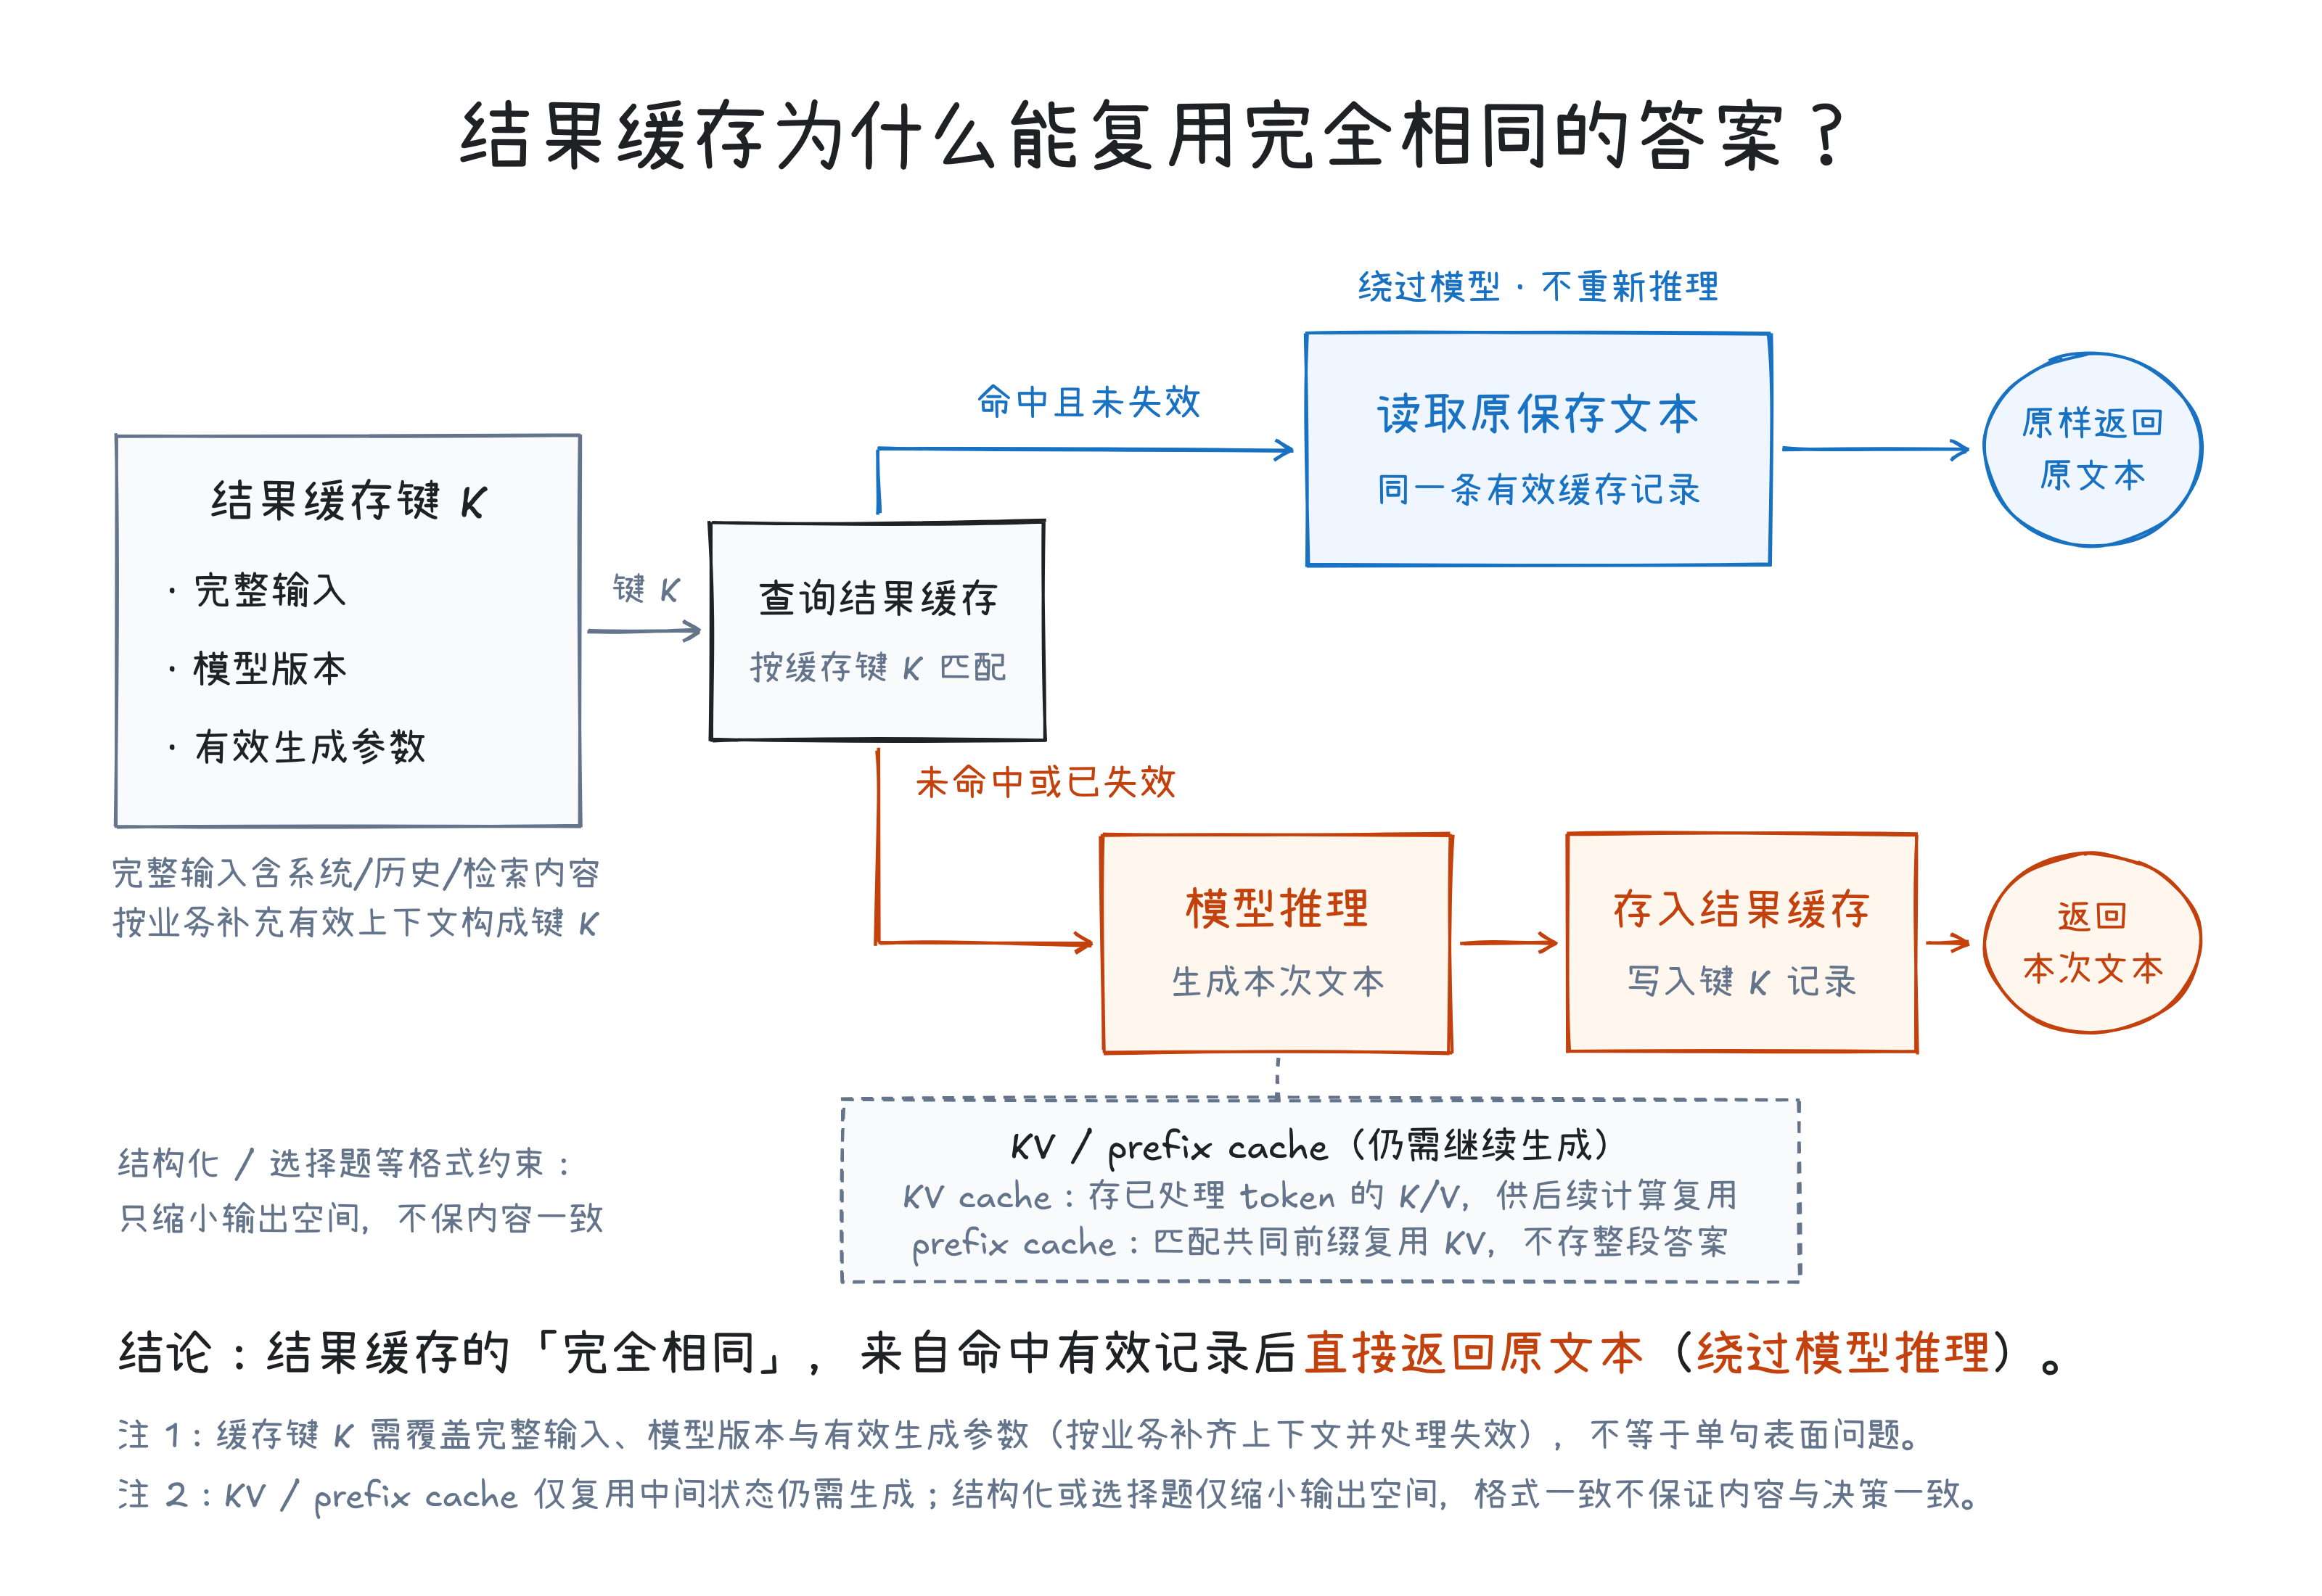
结果缓存保存完整生成文本供复用,缓存键 需包含完整输入、模型版本、生效参数及必要的业务上下文。只有多次命中同一键 、复用同一条有效缓存记录并原样返回时,才有逐字一致的文本,同时需承担缓存查询、网络传输及键与失效维护开销。
结果缓存与推理引擎内的 KV cache、prefix caching 作用不同 [9]:KV cache 保存当前序列已处理 token 的注意力键值张量,prefix caching 跨请求复用共享前缀的 KV 状态以跳过重复预填充(prefill),二者只复用中间状态,后续仍要继续算分和解码。
JSON Schema 等格式约束或单选、固定分档用于限定允许的输出格式或选项空间(仅靠提示词要求也不保证输出一定合规);即便实际输出满足格式或选项约束,当多个合法候选得分接近时,前向分数的微小变化仍可能改变最高分排名,因此格式合规或选项限制本身不能保证生成内容或业务结论一致。
稳定性指标与首个分歧点排查方法
验证输出稳定性时,可按目标区分三类衡量指标:
- 文本逐字一致:统计最终可见返回文本的逐字匹配率。不同 token 序列解码后可能拼出相同文字,因此最终返回文本相同不等于生成的 token IDs 序列一致。
- 语义一致:统计核心事实一致率或语义等价评估通过率。
- 业务一致:统计分类标签、结构化字段或分档结果的稳定率。
排查多次调用无法逐字一致(包括已配置贪心或零温度解码)的问题时,先核对完整输入 token 序列、服务端配置与运行环境是否一致,再结合生成接口的数据结构 [10] 定位首个分歧位置并做单变量对照。
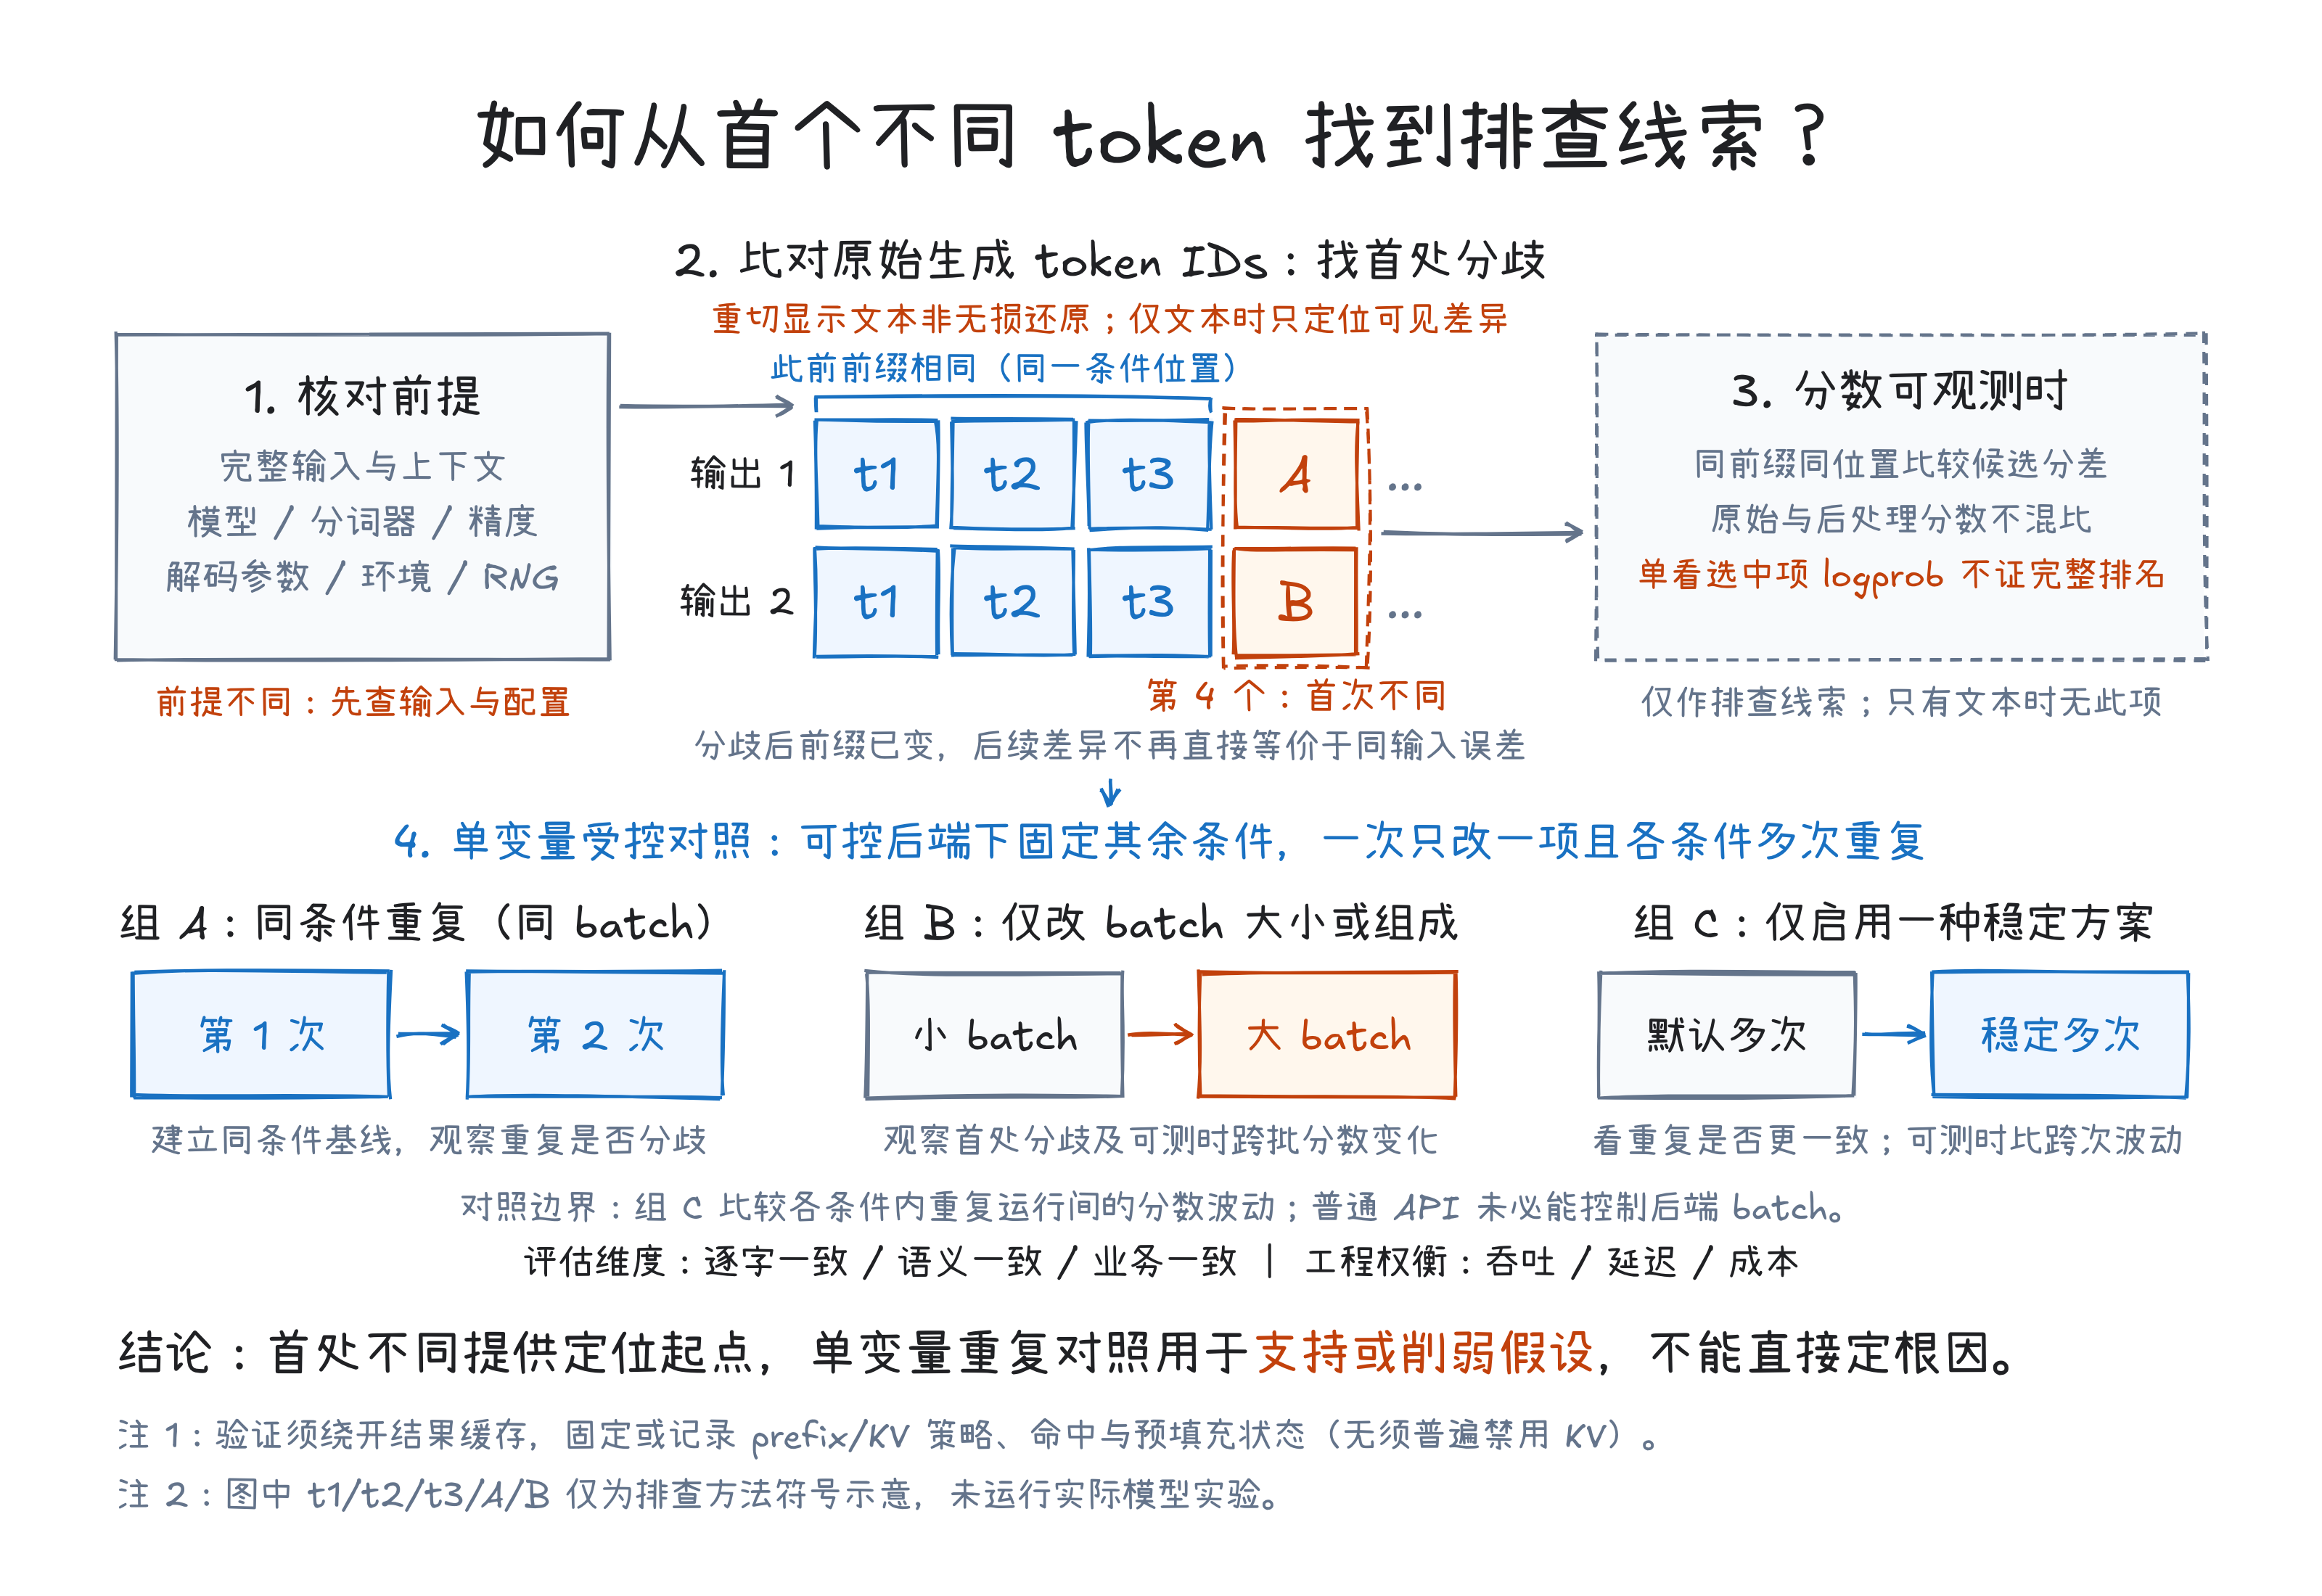
确认输入与配置对齐后,优先比对实际生成的 token IDs(如 sequences),找出首次选出不同 token 的位置。例如前三位同为 t1, t2, t3,第 4 位分别选出 A 和 B,第 5 位起输入前缀已变,不再按同一前缀下的分数误差比对。把显示的纯文本重新分词(re-tokenize)不保证无损还原原序列,若只有纯文本,只能定位首次可见字符差异。
在支持输出分数的后端上,固定首处分歧的同一前缀与位置,采用同一种分数定义与处理口径对比前列候选分数及 top-1 与 top-2 分差,不混用未处理的原始 logits 与后处理后的 scores [10]。仅凭所选词的单个 logprob 不足以还原完整候选排名。
若具备可控推理后端,测试前先绕开结果缓存,并固定或记录 KV cache 与 prefix caching 的策略、命中情况和 prefill 状态,保持各次运行条件可比,无须普遍禁用 KV cache。随后做三组单变量多次重复对照:
- 同条件重复测试:固定相同硬件、配置与相同 batch 多次重跑,检查生成序列与首处分歧位置的候选分数是否稳定。
- 单一批处理因素对照:固定目标请求与环境,每次只改一个 batch 因素(批大小或同批其他请求),每条件下多次重跑,观察跨 batch 是否出现选词差异与分数变化。
- 单一稳定措施对照:在默认配置与仅启用一种稳定措施下各自多次重跑,比较各条件内部的重复一致率。不同方案算出的绝对分值不必相等,也不以 top-1 与 top-2 分差趋零为指标。验证跨 batch 数值不变性时,需复用第 2 组那套不同的 batch 设置检验跨批一致性,仅固定单一 batch 重跑无法验证跨批不变性。
这三组对照可用于支持或削弱“动态 batch 改变归约顺序”“同批内存在非确定性操作”等假设,但不会直接指出具体是哪个算子内核产生偏差。排查能深入到哪一步取决于后端开放的观测字段与控制项:若外部 API 不返回完整候选分数、也不开放批处理配置,通常只能观察表层输出差异,不能仅凭输出不同直接定位底层算子或内核原因。
动态批处理影响的公开实验数据
Thinking Machines Lab 的一项公开实验展示了动态批处理对零温度输出的影响 [4]:使用 Qwen/Qwen3-235B-A22B-Instruct-2507(非思考模式),对提示词 "Tell me about Richard Feynman" 在 temperature=0 下重复生成 1000 次、每次 1000 个 token,默认推理服务下出现 80 种不同完整输出;启用其实现的 batch-invariant 内核后,1000 次输出全部一致。该结果是在特定模型、提示词与服务负载条件下测得的实验现象,并非本文实测,也不能当作所有模型与线上场景的普遍分歧率。
参考资料
[1] Hugging Face. Text Generation.
[2] Hugging Face. Generation Strategies.
[3] Hugging Face. Chat Templating.
[4] Thinking Machines Lab. Defeating Nondeterminism in LLM Inference.
[5] vLLM. Batch Invariance.
[6] PyTorch. Numerical Accuracy.
[7] PyTorch. Reproducibility.
[8] vLLM. Reproducibility.
[9] vLLM. Automatic Prefix Caching.
[10] Hugging Face. Utilities for Generation.